如何讓 Google 與 ChatGPT 找到這個 Astro 部落格?— robots.txt、JSON-LD、純文字版本與 IndexNow
我用四個做法讓這個部落格更容易被 Google 和 Bing 發現:在 robots.txt 逐一列出 AI 爬蟲、把 JSON-LD 放進 head、為每篇文章提供純文字版本,以及每次部署時送出 IndexNow。
本頁目錄
引言
我把部落格其中一篇文章的標題拿去 Google 搜尋,結果什麼都沒有。我已經在這個部落格上用三種語言發佈文章好幾個月了,Google 的索引裡卻連一篇也沒有。
我一開始懷疑問題出在 oharu-tech-blog.vercel.app 這個主機:它是 Vercel 底下的共用子網域,所以在搜尋引擎上的排名可能被壓低。但真正的原因其實很單純:這個網站從來沒有向任何搜尋引擎提交過,也沒有任何反向連結,而且 /robots.txt 還會回傳 404。
調查 SEO 的過程中,我也不禁好奇:ChatGPT 和 Claude 又是依據什麼來選擇要引用的文章?答案是 Bing 與 Brave 的搜尋索引,而不是 llms.txt,這個檔案幾乎沒有爬蟲會去抓。
現在這個部落格會在 robots.txt 裡逐一點名 AI 爬蟲,除了 HTML 頁面之外也同時提供每篇文章的純文字版本,並且會在每次部署時通知 Bing 有哪些新頁面。
Google 會對 vercel.app 主機限速,但照樣會抓取
*.vercel.app 是非常多專案共用的子網域,其中也有一些垃圾網站。因此搜尋引擎會對整個子網域限制抓取頻率並降低優先順序。*.vercel.app 也無法在 Search Console 註冊成網域資源,只能註冊成網址前置字元資源。
這些限制會壓低網站的排名。但網站即使放在評價偏低的主機上,還是會被抓取,所以主機的問題解釋不了我的部落格為什麼完全不在索引裡。搜尋引擎要發現新網站,主要透過兩種方式:
- 順著其他網站的連結過來
- 有人提交該網站的網站地圖
我的部落格兩者都沒有,Google 根本發現不了我的部落格。
我整理了幾個影響搜尋能見度(SEO)的問題,依影響程度排序如下:
| 問題 | 影響 |
|---|---|
| 從未提交網站地圖到 Search Console 或 Bing,在其他網站上也沒有這個部落格的反向連結 | Google 沒有任何途徑找到這個網站 |
*.vercel.app 共用子網域 | 搜尋引擎的抓取頻率受限,排名被壓低 |
/robots.txt 回傳 404 | 不會擋住爬蟲,但爬蟲不知道網站地圖在哪裡,也沒有對 AI 爬蟲的政策 |
hreflang 與 canonical 指向不同網址 | Google 可能忽略每篇文章的多語言版本對應 |
這個部落格每一頁都是靜態 HTML,沒有 X-Robots-Tag。sitemap-index.xml 回傳 200,並且三個語系都收錄在內,每篇文章也已經有 BlogPosting 節點。所以這個部落格一直都可以被抓取,只是我從來沒有讓爬蟲知道它的存在。
少了 robots.txt 並不會擋住任何東西,因為沒有這個檔案就代表「全部都可以抓」。真正缺少的是 Sitemap: 這一行,它負責告訴來訪的爬蟲網站地圖在哪裡。另外,網站也沒有任何針對 AI 爬蟲的政策說明。
針對搜尋引擎:hreflang、網域與 Search Console
為什麼 hreflang 與 canonical 會指向不同網址?
canonical 標籤(<link rel="canonical">)用來宣告一個頁面的正式網址。搜尋引擎只會索引這個正式網址;如果同一個頁面有兩個以上的網址,其他網址會被當成副本,不會被搜尋引擎收錄。
導覽連結、hreflang 與 RSS 摘要透過 src/i18n/config.ts 裡的 localeUrl() 來產生路徑,產生的路徑結尾沒有斜線。另一方面,canonical 標籤與 og:url 則是從 Astro.url.pathname 組出來的。靜態建置會把每一頁輸出成一個資料夾裡的 index.html(例如 blog/x/index.html),而資料夾的網址是 /blog/x/,所以 Astro.url.pathname 的結尾有斜線。
結果三種語言的每一篇文章,都同時帶著有斜線與沒有斜線的兩種網址:
<link rel="canonical" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/"><link rel="alternate" hreflang="en-US" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search">沒有斜線的網址,其實是同一頁的第二份副本。Vercel 對兩種路徑都回傳 200 和同一份 HTML,而 canonical 標籤只指向有斜線的網址。
Google 把 hreflang 當作提示;如果 hreflang 指向的不是 canonical 網址,Google 可能直接忽略它。也就是說,每篇文章的多語言版本對應都可能被 Google 捨棄,用日文搜尋的讀者可能會看到英文版的文章。
我把 localeUrl 改成一律補上斜線,讓 localeUrl() 和 Astro.url.pathname 產生的網址統一。只有路徑最後一段含有點號時例外,這樣 /rss.xml 與 /blog/<slug>.md 才能保留副檔名:
export function localeUrl(locale: Locale, path = "/"): string { const suffix = path.startsWith("/") ? path : `/${path}`; const isFile = suffix.slice(suffix.lastIndexOf("/") + 1).includes("."); const normalized = isFile || suffix.endsWith("/") ? suffix : `${suffix}/`; return `${localePrefix(locale)}${normalized}`;}重新建置之後,canonical 與 hreflang 兩個標籤都指向同一個網址,每個導覽連結也都改為指向 canonical 網址:
<link rel="canonical" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/"><link rel="alternate" hreflang="en-US" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/">網站地圖會為每個網址標上 lastmod,也就是頁面最後更新的日期,讓爬蟲知道哪些頁面需要重新抓取。scripts/lib/article-lastmod.ts 以網址為 key 存放這些日期,以前會自己在網址後面補一個斜線。localeUrl 開始輸出斜線之後,如果這支腳本再補一次,每個 key 的結尾都會變成 //,對不上網站地圖裡任何一個 <loc>(每筆項目的網址)。這樣一來,每篇文章的 lastmod 都會在沒有任何錯誤的情況下消失。所以我把這支腳本改成直接使用 localeUrl 的輸出。
我把網域搬到了 oharu121.com,Cloudflare 只負責 DNS
我最先挑的是一年三美元的 .click 網域,但 AI 代理反對這個選擇。這類便宜的新頂級網域雖然沒有直接的排名懲罰,卻很容易被大量拿去註冊垃圾網站,因此建立索引通常比較慢,別人也比較不願意連過來。所以我最後買了 oharu121.com。
我選擇直接用根網域 oharu121.com 作為部落格的網址,而不是 blog.oharu121.com 或 www.oharu121.com 這樣的子網域。我目前沒有其他網站會用到根網域,把根網域空著、部落格卻放在子網域上,並沒有意義;www.oharu121.com 則會以 308 重新導向到根網域。
我把 DNS 留在 Cloudflare,並永久關閉 Cloudflare 的代理功能(讓流量先經過 Cloudflare 伺服器的功能)。Vercel 本來就用自己的邊緣網路提供網站,再開代理等於多疊一層 CDN,部署之後這層 CDN 還可能繼續送出舊的 HTML。
另一個原因是,Cloudflare 的機器人與 AI 爬蟲規則只會作用在經過代理的流量上。新加入的網域會套用預設方案,而這些方案可能會封鎖 AI 代理類的爬蟲,或送出拒絕訓練的訊號,進而蓋過 robots.txt 的允許清單。因此只有不開代理、只用 Cloudflare 的 DNS,才能確保爬蟲政策以 robots.txt 為準。
用 CNAME 把根網域指向 Vercel
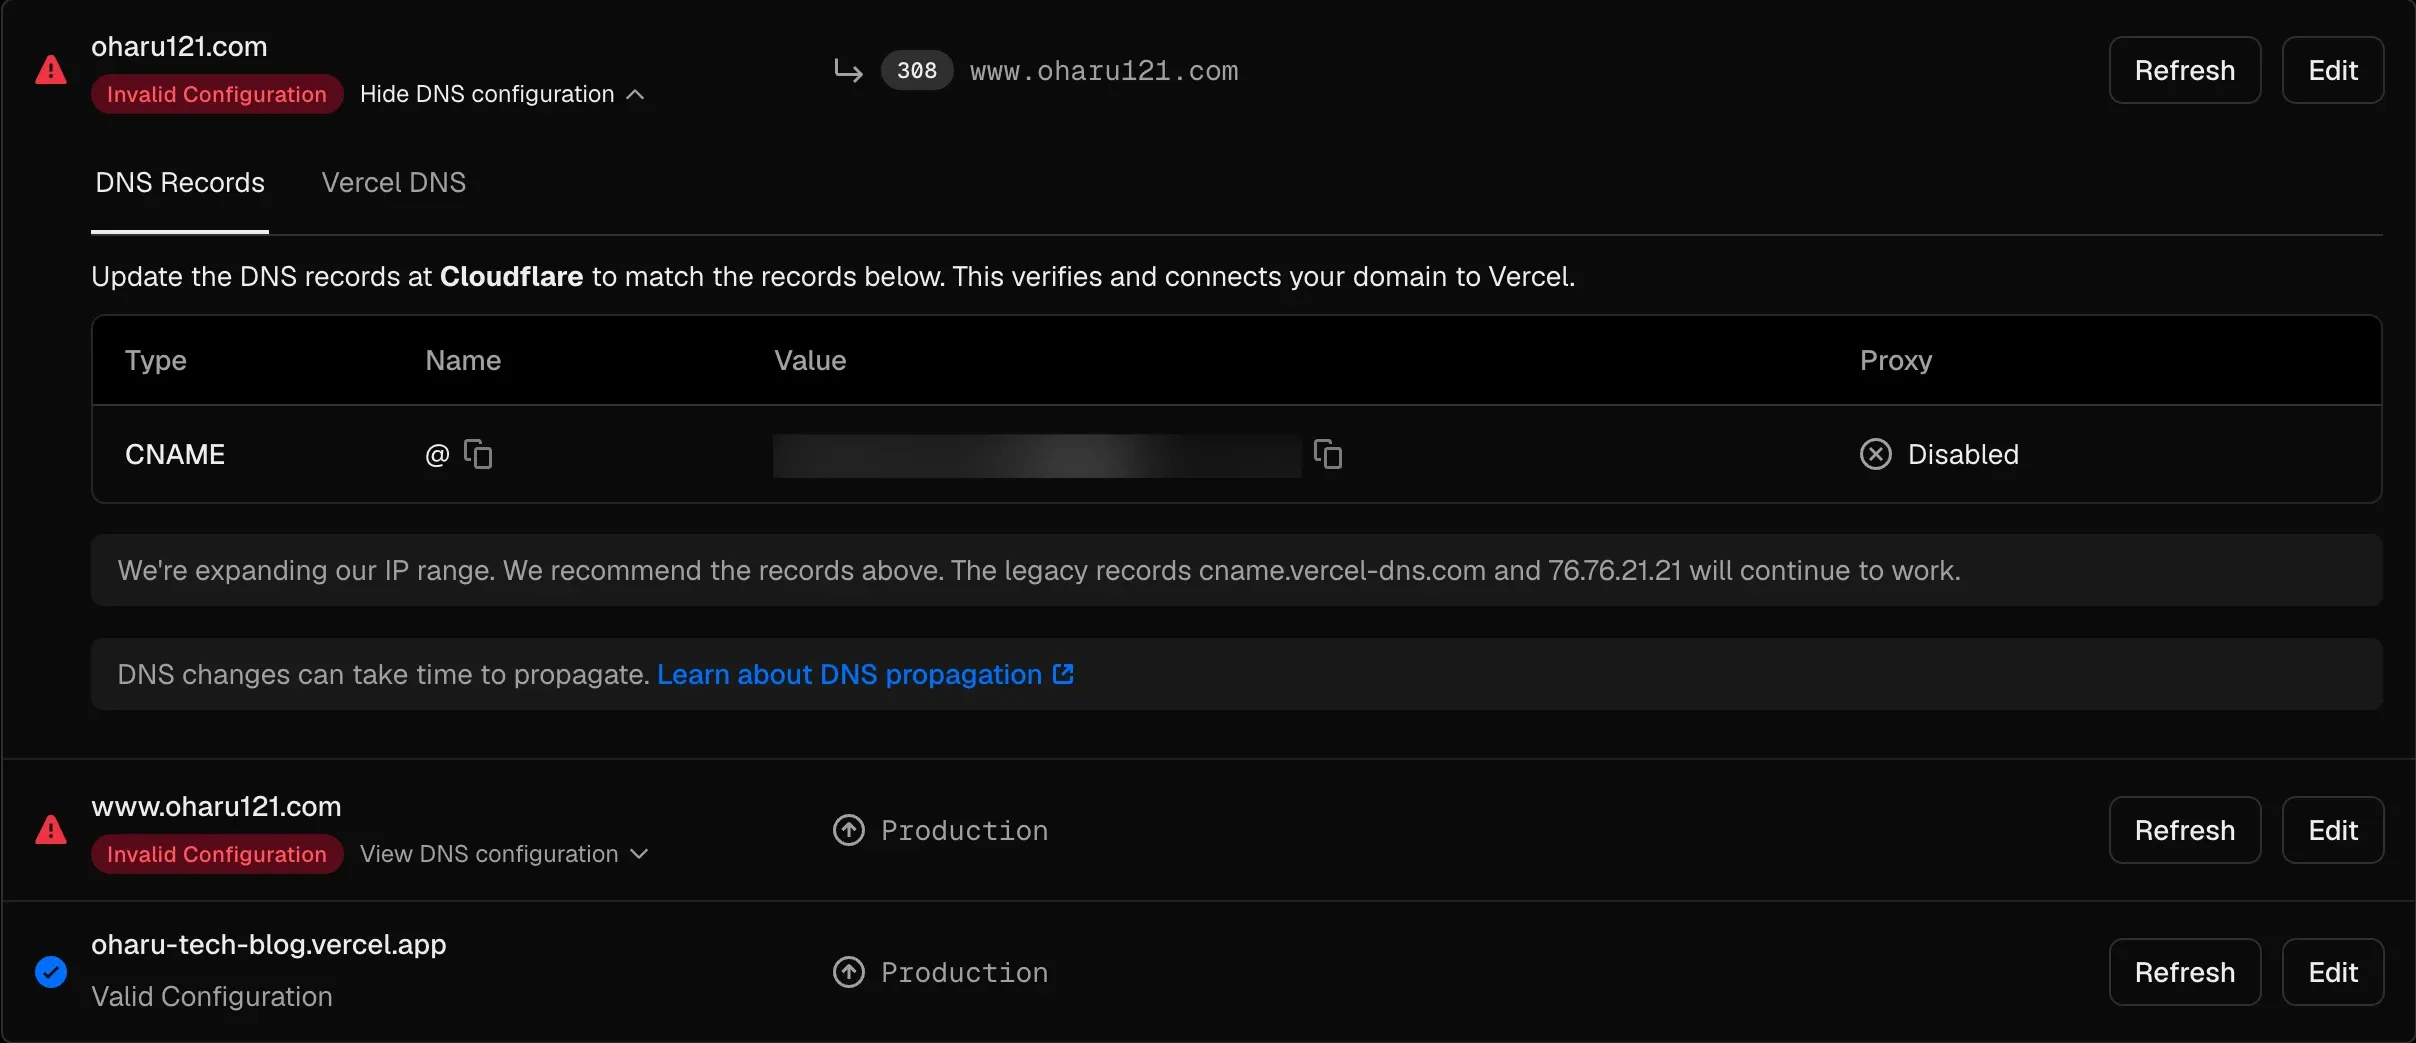
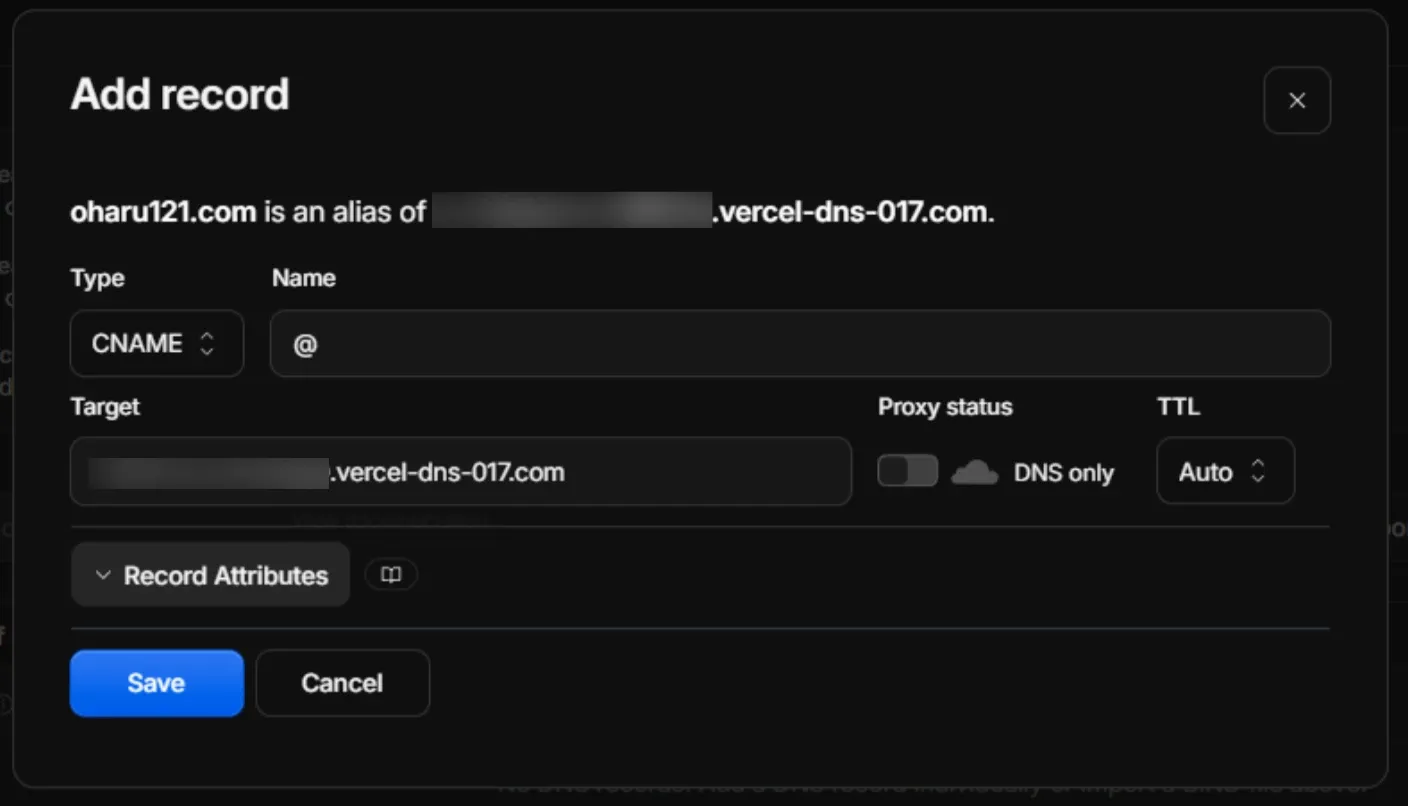
Vercel 要求在根網域放一筆 CNAME 記錄,指向這個專案專屬的主機名稱,而不是許多指南至今仍在引用的通用 cname.vercel-dns.com。
CNAME 記錄會把一個名稱設成另一個名稱的別名。查詢 oharu121.com 時,DNS 會被告知「這是 xxxx.vercel-dns-017.com 的別名」,於是改去查詢這個 Vercel 為專案產生的主機名稱,最後拿到它的 IP 位址。A 記錄則是把名稱直接綁定到一個固定的 IP 位址,IP 一變就得修改記錄;用 CNAME 的話,由 Vercel 負責讓目標名稱對應到最新的 IP,我這邊不需要修改任何設定。
但 DNS 規範不允許在根網域放 CNAME。根網域一定要有 NS 記錄(負責回答這個網域查詢的伺服器)與 SOA 記錄(網域的管理資訊),而 CNAME 代表「這個名稱的一切都以另一個名稱為準」,會和這兩筆記錄衝突。
這樣設定仍然能運作,因為 Cloudflare 從來不會真的對外送出這筆 CNAME。CNAME 扁平化(CNAME flattening)是 Cloudflare 自己的功能,而不是 DNS 標準:Cloudflare 會先查好 CNAME 目標的 IP,再以一般的 A 記錄回應。如果 DNS 供應商沒有這類功能,Vercel 的知識庫建議在根網域改用 A 記錄 76.76.21.21。Vercel 的設定頁面也註明了這筆 A 記錄仍然可以使用。
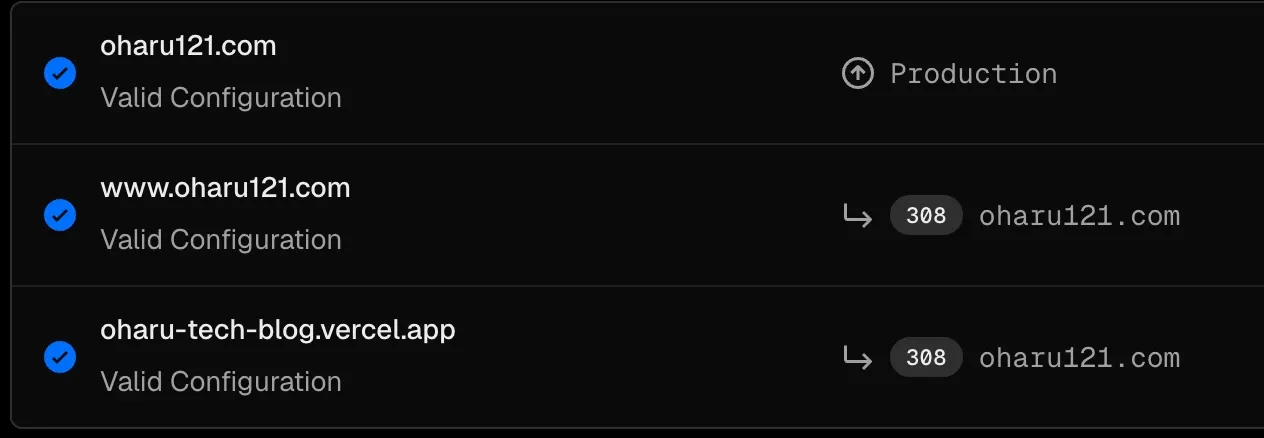
舊主機對每一條路徑都回傳 308(永久重新導向),把請求導向新網域上的同一條路徑,例如舊主機的 /blog/x/ 會導向新網域的 /blog/x/。跟著重新導向走的爬蟲完全讀不到舊頁面,所以這樣合併兩個主機,比只靠 canonical 標籤更徹底。
在程式碼這邊,我只改了一行就完成了搬遷。網站上所有絕對網址,包括 robots.txt 的 Sitemap:、網站地圖、RSS、llms.txt、canonical 標籤與 IndexNow 腳本,都是由同一個常數 SITE 組出來的:
export const SITE = "https://oharu121.com";我在 Search Console 提交了網域資源
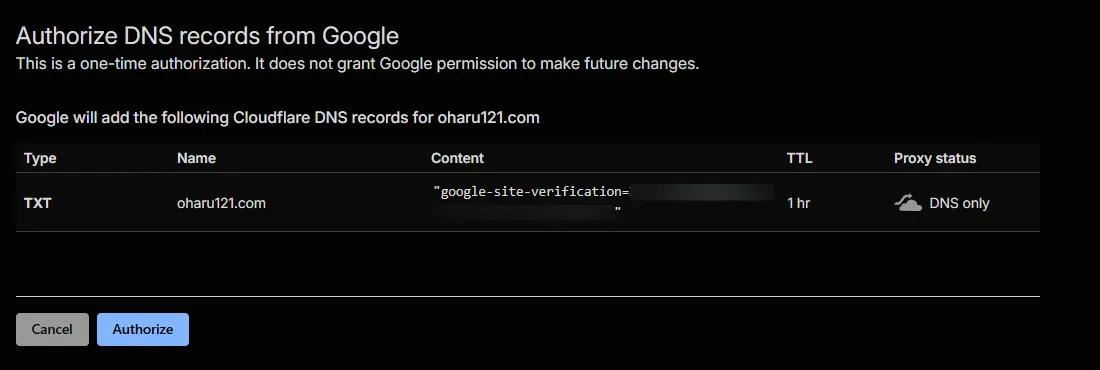
Search Console 的網域資源是用 DNS TXT 記錄來驗證的,一次就能涵蓋根網域、www、HTTP 與 HTTPS,以及未來的任何子網域。Google 與 Cloudflare 之間有一個一次性的授權流程,會自動替我寫入這筆 TXT 記錄。
我一開始只用 sitemap-index.xml 這個路徑提交網站地圖,結果出現了 「Invalid sitemap address. Please enter a valid path to a sitemap in your site.」 錯誤。必須填入完整網址:https://oharu121.com/sitemap-index.xml。
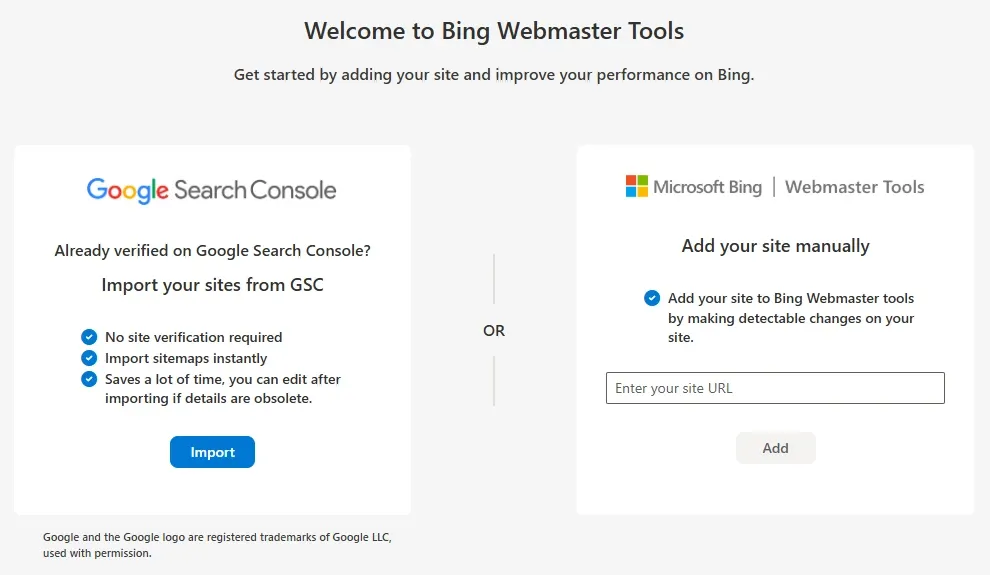
我在 Bing Webmaster Tools 直接從 Search Console 匯入了驗證與網站地圖,所以不必在 Bing 另外驗證網站或提交網站地圖。
針對回答引擎:robots.txt、llms.txt、JSON-LD、純文字版本、IndexNow 與 Brave
我在 robots.txt 逐一列出了十一個 AI 爬蟲
我把 robots.txt 改成由 src/pages/robots.txt.ts 這個路由產生,這樣 Sitemap: 這一行就會從 SITE 常數組出來,換網域時也會跟著改。政策由我決定:放行所有 AI 爬蟲,包含蒐集訓練資料等所有用途。這個部落格的目的就是觸及更多人,而訓練語料庫也是文章裡的想法能被讀到的途徑之一。
即使 User-agent: * 搭配 Allow: / 已經允許所有爬蟲抓取整個網站,我還是把十一個爬蟲逐一列了出來,讓每個爬蟲都有自己的開關:
# OpenAI — training data for future modelsUser-agent: GPTBotAllow: /
# OpenAI — the index behind ChatGPT searchUser-agent: OAI-SearchBotAllow: /訓練與檢索用的是不同的爬蟲,開關也各自獨立:封鎖其中一個,其他爬蟲還是會照樣運作。Anthropic 在文件中列出了三個爬蟲:
ClaudeBot:蒐集訓練資料Claude-SearchBot:建立搜尋索引Claude-User:替使用者抓取他指定的頁面
因為每個爬蟲在 robots.txt 中都有屬於自己的一行,之後想改變對某個爬蟲的政策,只要把那個爬蟲的那一行改成 Disallow 就好。想在回答中被引用、卻不想被拿去訓練的網站,只要封鎖訓練用的爬蟲即可。
ChatGPT-User 與 Claude-User 都是代替使用者抓取他指定頁面的爬蟲,但兩家廠商對 robots.txt 的處理不同。OpenAI 的文件寫明(中譯):「由於這些動作是使用者發起的,robots.txt 規則可能不適用」,所以對 ChatGPT-User 寫 Disallow 只是一種請求。Anthropic 的文件則表示旗下所有爬蟲都遵守 robots.txt,Claude-User 也包含在內。
三家廠商的八個爬蟲如下,每一格都是獨立的 robots.txt 開關:
| 廠商 | 訓練 | 搜尋索引 | 使用者發起 |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User(robots.txt 可能不適用) |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | 未公開 | PerplexityBot | Perplexity-User |
有誰在讀 llms.txt?
llms.txt 是一份用 Markdown 寫成的網站索引,放在網站根目錄的 /llms.txt,但幾乎沒有爬蟲在讀。根據 Limy 的觀測,九十天內 llms.txt 只被請求了大約 408 次,同期 AI 機器人的造訪則超過五億次。沒有任何主流的 AI 廠商表示會在 production 環境讀取這個檔案。
提供 llms.txt 的網站很多,真正去讀它的爬蟲卻很少。根據 Rankability 的統計,Tranco 網站排名(一份常用的熱門網站清單)前一千名中約有 8.7% 提供 llms.txt;在某些以開發者網站為主的樣本中,這個比例更超過一半。
不過,IDE 裡的 AI 代理與 MCP 伺服器確實會抓取 llms.txt,而這個部落格的讀者正是開發者。所以我還是做了 llms.txt,但只做成一份小型索引,每個語系一份,產生方式和 RSS 摘要相同。
我把 JSON-LD 放進了 <head>,並用 @id 串起來
每篇文章原本就有一個 BlogPosting 節點,但它輸出在 <body> 裡,也沒有 publisher、url 或 keywords。我改成由 src/lib/schema.ts 產生 JSON-LD 並放進 <head>,文章頁另外輸出 BreadcrumbList,列表頁則輸出 WebSite、Blog 與 ItemList。
以這個部落格的一篇文章為例,<head> 裡的 JSON-LD 節錄如下:
{ "@type": "BlogPosting", "headline": "RAG vs fine-tuning for KB search — …", "url": "https://oharu121.com/blog/rag-vs-finetuning-kb-search/", "datePublished": "2026-08-11T15:07:58+09:00", "inLanguage": "en-US", "author": { "@type": "Person", "@id": "https://oharu121.com/#person", "name": "oharu" }, "isPartOf": { "@id": "https://oharu121.com/#website" }, "keywords": "RAG, LLM, Generative AI, Machine Learning"}每一頁都用固定的 @id 指向同一個作者節點與同一個網站節點。@id 的寫法是在網站網址後面加上 #person 或 #website 這樣的片段:
const personId = (site: URL) => new URL("#person", site).href;const websiteId = (site: URL) => new URL("#website", site).href;這樣一來,不管爬蟲讀了這個部落格的哪幾個頁面,都會認定作者是同一個人,而不是好幾個同名的人。
把 JSON-LD 寫進頁面的序列化函式,會把每個 < 跳脫成 \u003c。這是因為 JSON.stringify 不會處理 </script>:只要 JSON-LD 的字串裡出現 </script>,<script> 標籤就會提早結束,剩下的 JSON-LD 會被當成 HTML 漏到頁面上。
WebSite 節點沒有加上 SearchAction。這個屬性原本是讓 Google 在搜尋結果裡顯示網站連結搜尋框,但 Google 已在 2024 年 11 月移除了這個功能;而且這個部落格的搜尋頁也不讀 ?q= 參數,加上去只會宣告一個無法使用的搜尋網址。
在 Search Console 的網址審查中,可以看到 Google 讀到了 BreadcrumbList 節點:
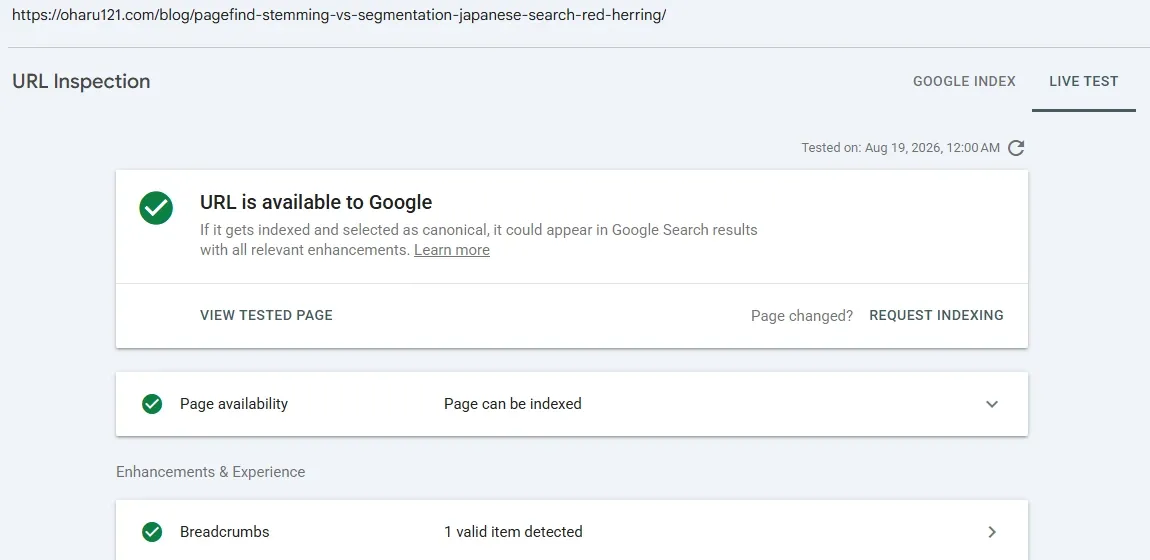
schema.ts 輸出的 BreadcrumbList 節點。我替每篇文章提供了 Markdown 純文字版本
在每篇文章的網址後面加上 .md,例如 /blog/<slug>.md,就能拿到這篇文章的 Markdown 純文字版本;文章的 <head> 也會用 <link rel="alternate" type="text/markdown"> 指向這個版本。這樣一來,回答引擎就能直接拿到純文字的內文,不用再從 HTML 頁面裡解析出內容。
這個部落格的每篇文章都會 import 元件,但 Astro 元件沒有對應的 Markdown 寫法。src/lib/mdx-to-markdown.ts 會把每一種元件轉成文字:
- 移除 import。
- 把
<Callout>換成帶標籤的引言區塊。 - 把
<Figure>換成圖說加上圖表名稱。 - 點陣圖只保留替代文字,拿掉圖片網址。這是因為建置後的圖片路徑含有依檔案內容算出的雜湊值,轉換程式無從得知;如果模型引用了一個會回傳 404 的連結,只會把壞掉的網址繼續傳出去。
import Callout from '@/components/article/Callout.astro';import Figure from '@/components/article/Figure.astro';import RagVsFinetuning from './_figures/RagVsFinetuning.astro';
<Callout type="know">Fine-tuning changes behaviour, not facts.</Callout>
<Figure> <RagVsFinetuning /> <Fragment slot="caption">RAG keeps facts outside the model.</Fragment></Figure>
> **話說**>> Fine-tuning changes behaviour, not facts.
*Figure — RagVsFinetuning: RAG keeps facts outside the model.*
*Image: A bar chart of answer accuracy*內文、標題、表格與程式碼區塊這四種內容都原樣保留,而值得讓回答引擎引用的內容幾乎全在這些地方。
我用 IndexNow 在每次部署時把網址推進 Bing 的索引
Bing 的索引是 ChatGPT 搜尋引用的來源之一,但這部分佔多少比例還有爭議。Seer Interactive 在 2025 年 2 月用 100 個查詢測試,發現 SearchGPT 有 87% 的引用與 Bing 的前幾名結果相符;2026 年 4 月一份用 400 個查詢的重現研究,卻只得到 27%。不管哪個數字才對,Bing 沒有抓取過的頁面,都不可能經由 Bing 被引用。
IndexNow 是一個讓網站主動通知搜尋引擎「這些網址有更新」的協定。只要把網址送到 api.indexnow.org 這一個端點,就能同時通知 Bing、Yandex、Seznam、Naver 等搜尋引擎。Google 沒有參與 IndexNow,所以 Google 這邊仍然要透過 Search Console 另外處理。
IndexNow 要確認送出網址的人能控制這個網站,靠的是一個金鑰檔案:檔名就是金鑰本身,內容也是同一串金鑰,放在網站根目錄。IndexNow 驗證時,就是把這個檔案抓下來比對。我把它 commit 在 public/ 底下,scripts/indexnow.ts 也從同一個檔案讀取,所以送出的金鑰永遠與網站上提供的一致。
buildLastmodMap 原本就會為網站地圖列出每篇已發布文章的網址與 lastmod,所以 scripts/indexnow.ts 直接從這份清單篩出最近一段期間內更新過的網址,不必另外比對 git 差異。
70 URL(s) for oharu121.com: …IndexNow accepted the batch (200).我讓 CI 在每次正式部署後執行 pnpm indexnow。第一次執行回傳了 202,代表 IndexNow 已收到請求、但金鑰驗證還在處理中;之後每次都回傳了 200。
接著我在 Bing Webmaster Tools 檢查了網址,結果出現了紅色叉號:
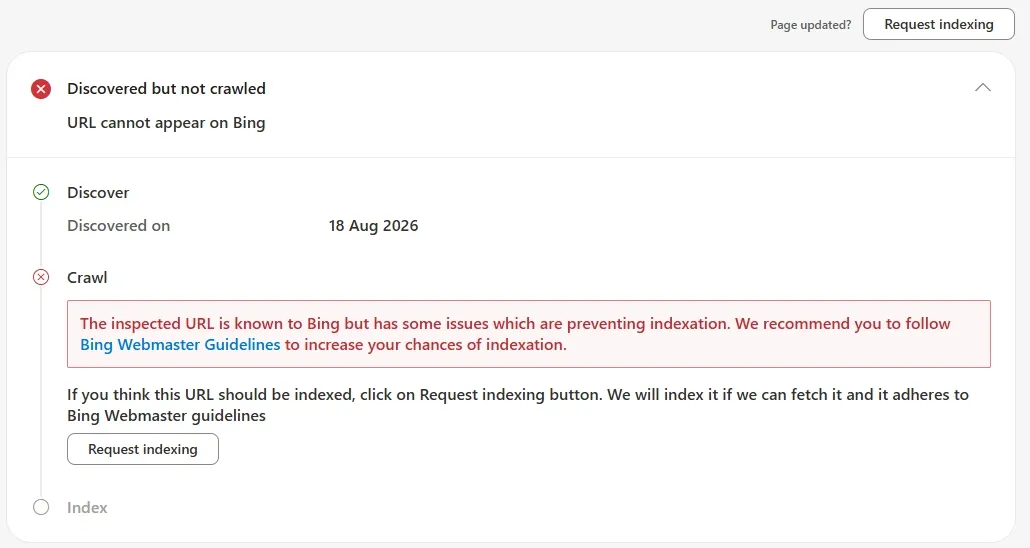
「Discovered but not crawled」代表頁面正在排隊等待 Bing 抓取。畫面上的 Discovered on 18 Aug 2026,就是 IndexNow 送出網址的那一天。一個上線才幾天、又沒有反向連結的網域,檢索配額(搜尋引擎願意抓取這個網站的頁面數量)幾乎是零。IndexNow 能讓 Bing 知道這個網址存在,但什麼時候來抓,仍然由 Bing 決定。
Claude 的網路搜尋靠的是 Brave,而 Brave 不接受網站主動提交網址
Claude 的網路搜尋幾乎可以確定是使用 Brave Search。Anthropic 沒有公開說明搜尋供應商,但根據 Simon Willison 的發現,Anthropic 在 2025 年 3 月 19 日、也就是 Claude 網路搜尋上線的前一天,把 Brave 列為網路搜尋的子處理者(替 Anthropic 處理資料的外部服務商)。此外,Claude 引用的來源也和 Brave 的前幾名搜尋結果一致。
Brave 沒有站長控制台,不收網站地圖,也沒有參與 IndexNow。根據 MERJ 的分析,Brave 的爬蟲不使用自己的使用者代理字串,而是遵守 robots.txt 裡給 Googlebot 的規則。這個部落格用 User-agent: * 放行了所有爬蟲,所以 Brave 的爬蟲本來就進得來。
Brave 主要靠頁面在 Google 與 Bing 的排名來發現新頁面。另一個來源是 Brave 瀏覽器中加入 Web Discovery Project 的使用者,他們會回報自己造訪過的頁面。search.brave.com/submit-url 只是請 Brave 重新抓取它已經知道的頁面,無法用來提交新網址。
總結
- 這個部落格沒被 Google 收錄,是因為從未提交網站地圖,也沒有反向連結。
- 共用的
*.vercel.app主機會被限制抓取頻率、壓低排名,但 Google 照樣會抓取。 llms.txt在一份觀測中面對五億次 AI 機器人造訪,只被請求了大約 408 次。我只把它做成給 IDE 裡的 AI 代理使用的小型索引。- IndexNow 在每次部署時把網址推進 Bing 的索引,而 Bing 是 ChatGPT 搜尋引用的來源之一。
- Claude 的網路搜尋靠的是 Brave;Brave 不接受網站主動提交網址,主要依據頁面在 Google 與 Bing 的排名來發現新頁面。
- 每篇文章的純文字版本,讓回答引擎不必解析 HTML 頁面就能拿到內文。
參考連結
- Google Search Console 的網站地圖報表,包含網域資源與網址前置字元資源的差異
- Google Search Central 的〈To slash or not to slash〉,說明結尾有無斜線的網址會被視為不同頁面
- OpenAI 的爬蟲文件,列出 GPTBot、OAI-SearchBot 與 ChatGPT-User,以及使用者發起的抓取對 robots.txt 的但書
- Anthropic 的爬蟲文件,說明 ClaudeBot、Claude-SearchBot 與 Claude-User 可以各自獨立封鎖
- Limy 的 llms.txt 指南,包含五億次 AI 機器人造訪對上 408 次請求的數據
- Rankability 對 Tranco 前一千名網站導入 llms.txt 的統計
- Seer Interactive 比較 SearchGPT 引用與 Bing、Google 搜尋結果的研究
- 以 400 個查詢重現 Bing 與 ChatGPT 引用重疊程度的研究
- Simon Willison 指出 Brave Search 在 Claude 網路搜尋上線前一天被列入 Anthropic 子處理者清單
- MERJ 分析 Brave Search 如何發現頁面,並引用 Brave 爬蟲文件中關於遵守 Googlebot 規則的說明
- Cloudflare 關於新網域 AI 爬蟲預設方案的公告
- Cloudflare 的 CNAME 扁平化文件,說明如何以 A 記錄回應根網域的 CNAME
- Vercel 以 A 記錄將網域指向 Vercel 的指南
- IndexNow 通訊協定規格,包含金鑰檔案的要求與回應碼
- Vercel 關於避免 vercel.app 網址與自訂網域重複內容的指南