我用 Terraform 接管了在 AWS 主控台手動建立的 AWS production 環境 — 保留各項 AWS 資源的名稱,並在 CI 擋下 Terraform 可能意外導致的刪除
用 Terraform import 區塊把在 AWS 主控台手動建立的資料層交給 Terraform 管理,並保留各項 AWS 資源原本的名稱。production 環境由我手動套用,套用前會先檢查 plan,只要有 AWS 資源會被刪除就會中止。
本頁目錄
引言
我參與開發的一個 AWS 資料層分成測試帳戶和 production 環境,其中測試帳戶是用 Terraform 建立的。建立時使用的模組,是我以唯讀方式擷取 production 的設定之後寫成的。詳細的做法寫在我之前寫的 Terraform 重建文章裡。那篇文章也提到,之後要讓 production 也使用同一個模組時,「只需要新增一個 tfvars 檔案」。
但 production 本身仍然是在主控台手動建立、手動修改的。我希望 production 也由同一個模組定義,並且由我手動啟動套用。但是當我第一次對 production 執行唯讀的 terraform plan 時,plan 竟然列出有 7 個資源要被刪除,這是因為主控台給這些資源取的名稱和模組產生的名稱不同。
現在,在 production 套用 Terraform 時會匯入既有的資源,並保留各項 AWS 資源原本的名稱。兩個帳戶都改由 Terraform 管理,合併到 main 時會部署到測試環境;只有透過手動啟動的 workflow 才會部署到 production,而且這個 workflow 會拒絕任何會刪除 AWS 資源的 plan。
一個模組、兩個 root、兩種套用方式
兩個帳戶使用同一個資料層模組,但各自有自己的 root 目錄和 state。state 是 Terraform 記錄自己管理了哪些資源的檔案;每個 root 各有一份,所以兩個帳戶的資源不會混在一起。root 是執行 terraform plan 的目錄,裡面放了三樣東西:
- backend:指定 state 存放的位置,例如 S3 bucket。
- provider:設定 Terraform 要操作的 AWS 帳戶,每個 root 只指向其中一個帳戶。
module區塊:呼叫資料層模組,並傳入這個帳戶專用的值。
modules/ bootstrap/ state bucket 與 GitHub Actions 的 role,兩個帳戶共用 data-layer/ S3、Glue、OpenSearch Serverless、Bedrock knowledge base、Lambda、AgentCorebootstrap/ test/ prod/envs/ test/ main.tf prod/ main.tf, imports.tfproduction 的 root 和測試帳戶的 root 只有兩個地方不同:
imports.tf:把模組裡的資源對應到 production 已經存在的資源。main.tf:把這些資源在主控台原本的名稱傳給模組。
每個 pull request 都會為兩個帳戶各執行一次 plan。pull request 合併到 main 時會套用到測試帳戶;production 則只有在我手動啟動 workflow 時才會套用。如果 plan 裡有任何資源會被刪除,production 的這次執行就會在套用任何東西之前失敗。
因此,如果在主控台修改了 production,下一個 pull request 的 production plan 就會把這項修改列成和程式碼之間的差異。下一次套用到 production 時,這項修改會被改回程式碼的設定;如果改回去需要刪除資源,刪除檢查就會中止這次執行。
用唯讀的 plan 預演接管 production 上的資源
只要結合 import 區塊和本機 backend,terraform plan 就能顯示套用後 production 上的資源會發生什麼變化,而且在這個階段還不會改變 production 上的任何資源。import 區塊會寫明一個既有的資源,以及這個資源在模組中要對應到的位址。plan 會讀取實際運行中的資源,和 Terraform 的設定比對,並在真正匯入之前列出差異。
我呼叫 AWS 的 List、Get 和 Describe 類 API,收集了各資源的 ID,並替每個資源寫了一個 import 區塊。結構重複的資源則用 for_each 一次處理:
import {  to = module.data_layer.aws_bedrockagent_knowledge_base.this["handbook"]  id = "KBID000001"}
import {  to = module.data_layer.aws_bedrockagent_data_source.this["handbook"]  id = "DSID000001,KBID000001"}
import {  for_each = local.buckets  to       = module.data_layer.aws_s3_bucket.this[each.key]  id       = each.value}
production 的 main.tf 把 state 設定存放在一個 S3 bucket 裡,但這個 bucket 當時還不存在,所以 terraform plan 根本無法執行;而且預演本來就不該把 state 寫進 production。
如果添加名稱以 _override.tf 結尾的檔案,Terraform 會優先拿它的內容覆蓋其他檔案裡的同一段設定,而且覆寫檔案裡的 backend 區塊會優先於原本的 backend 區塊。所以只要放一個暫時的覆寫檔案,就能讓 state 改存到本機磁碟,完全不用動到 main.tf,自然也就不需要 S3 bucket 了:
terraform { backend "local" { path = "/tmp/prod-rehearsal.tfstate" }}使用 production 的憑證執行時,plan 會讀取每一個資源,但不會改動帳戶裡的任何東西:
輸入aws-vault exec prod -- terraform -chdir=terraform/envs/prod plan -lock=false輸出Plan: 44 to import, 17 to add, 23 to change, 7 to destroy.等 production 的 state bucket 建好之後,我刪除了覆寫檔案,這樣同一個指令就會改用 S3 backend 存放 state 了。
為什麼 plan 要替換 7 個資源?
7 個要替換的資源裡,有 6 個是因為名稱不同。我在 AWS 主控台建立這些資源時,主控台自動產生了名稱,而模組則依自己的規則組出的是另一個名稱。另外有一條 inline policy,因為它所屬的 role 要被替換,所以也跟著被替換。
Terraform 無法直接把 knowledge base 的資料來源或 IAM role 改名。只要名稱不同,Terraform 就只能先建立一個新的資源,再刪除舊的:
# module.data_layer.aws_bedrockagent_data_source.this["catalog"] must be replaced    ~ name = "knowledge-base-quick-start-xxxxx-data-source" -> "app-catalog-s3" # forces replacement
# module.data_layer.aws_iam_role.kb["catalog"] must be replaced ~ name = "AmazonBedrockExecutionRoleForKnowledgeBase_xxxxx" -> "app-kb-catalog" # forces replacement| 資源 | 替換數量 | 替換的代價 |
|---|---|---|
| knowledge base 的資料來源 | 2 | 資料來源 ID 會改變,所有文件都要重新同步到 knowledge base |
| knowledge base、Lambda 和 gateway 的 IAM role | 4 | 新的 role 會先建立,其他資源之後才改為指向它,所以在切換生效之前,呼叫可能會因為 AccessDenied 而失敗 |
| Lambda role 的 inline policy | 1 | 跟著它的 role 一起重建 |
其中一個 knowledge base 帶有模組沒有宣告的 aws-apn-id 標籤,所以 plan 裡也列出了移除這個標籤的變更。plan 還把 AgentCore 的 service-linked role 列為要新建立的資源,但 production 裡已經有一個了,所以套用原本會在建立它時失敗。
依照 knowledge base 名稱命名的資料來源
模組原本會用 knowledge base 的名稱,組出每個資料來源的名稱。後來我在主控台替一個 knowledge base 改了名,並把模組裡的名稱也改成新名稱。knowledge base 本身可以直接改名,所以 plan 只把它列為原地更新。但資料來源的名稱是從 knowledge base 的名稱組出來的,也跟著變了;資料來源無法直接改名,所以 plan 把它列為要替換的資源。
我讓每個資料來源改用自己的固定名稱,不再從 knowledge base 的名稱組出來:
resource "aws_bedrockagent_data_source" "this" { name = "${replace(each.value.name, "_", "-")}-s3" name = each.value.data_source_name # …}改完之後,測試帳戶的 plan 就從 1 to add, 1 to change, 1 to destroy 變成了 0 to add, 1 to change, 0 to destroy。
用 existing_names 保留主控台的名稱
我加了一個選填的變數,用來存放主控台取的名稱;當這個變數沒有值時,模組就照自己的規則產生名稱。測試帳戶不傳入任何值,所以沿用原本的名稱;production 則傳入主控台裡原本的名稱:
variable "existing_names" { type = object({ data_sources = optional(map(string), {}) kb_roles = optional(map(string), {}) reviewer_role = optional(string) gateway_role = optional(string) }) default = {}}resource "aws_iam_role" "kb" { name = lookup(var.existing_names.kb_roles, each.key, "${local.prefix}-kb-${each.key}") # …}剩下的兩個問題,也就是 aws-apn-id 標籤會被移除、service-linked role 會被重複建立,各只需要一行就能解決。在 knowledge base 上加上 ignore_changes = [tags["aws-apn-id"]],Terraform 就不會去動那個標籤;替 service-linked role 寫一個 import 區塊,它就從新建改成匯入既有的 role。
輸入aws-vault exec prod -- terraform -chdir=terraform/envs/prod plan -lock=false輸出Plan: 45 to import, 9 to add, 28 to change, 0 to destroy.這 9 個新增都不會改動任何既有的東西,內容分成四類:
- 納入管理的 role 上的三條 inline policy
- 同樣在這些 role 上的兩個 policy attachment
- 一條新的 OpenSearch data access policy
- 確認 index 存在的
terraform_data,以及接在它後面的time_sleep
測試帳戶的 plan 仍然輸出 No changes. Your infrastructure matches the configuration.。
為什麼我保留了資源的舊名稱?
當初做決定時,考量的是切換期間權限會中斷一段時間。改用模組的名稱,代表 Terraform 要先建立每個新的 role,把 knowledge base、Lambda 或 gateway 指向它,再刪除舊的 role。在這段期間,任何呼叫都可能失敗。
不過,保留名稱也有代價。每個納入管理的 role 都同時帶著主控台附加的 managed policy 和模組的 inline policy,同樣的權限有了兩份。我把這一點加進了快照差異比對指令碼的預期差異清單(EXPECTED_DIFFS),並註明了原因。
手動套用 Terraform 到 production,並先進行刪除檢查
production 只有在我用 target: prod 手動觸發 workflow_dispatch 時才會套用,而且 job 套用的就是它檢查過的那份 plan。workflow_dispatch 是 GitHub Actions 用來手動啟動 workflow 的觸發條件。target 設成選擇式輸入、預設為 test,所以測試帳戶原本的流程不受影響:
on:  workflow_dispatch:    inputs:      target:        description: apply する環境        type: choice        options: [test, prod]        default: test
jobs:  apply-prod:    if: github.event_name == 'workflow_dispatch' && inputs.target == 'prod'    environment: prod    env:      TF_DIR: terraform/envs/prod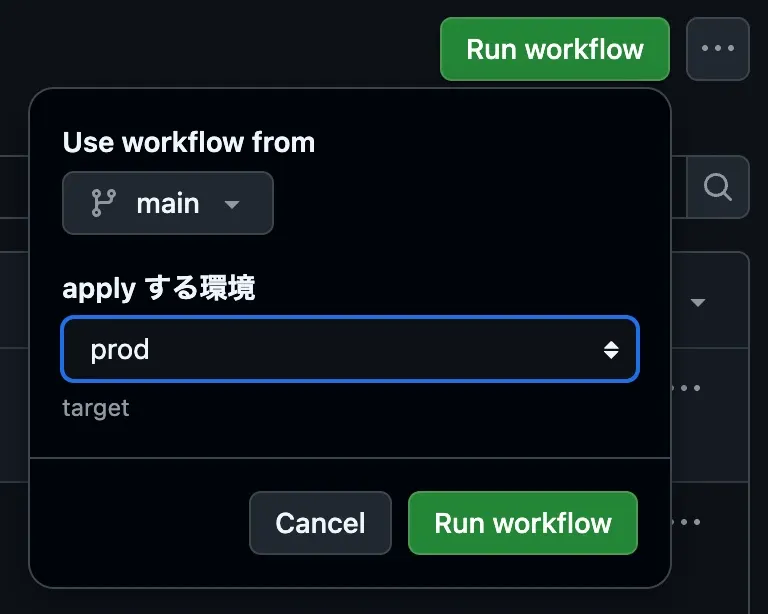
prod environment 只能從 main 部署。這個限制是用 deployment branch policy 設定的,做法和我之前寫的 Terraform 重建文章替 test 設定的一樣。這個 environment 沒有設定必要的審查者,所以套用前不需要任何人核准。AWS 的 apply role 只信任來自 prod environment 的 OIDC token(token 的 subject 必須指向這個 environment)。
刪除檢查會把存下的 plan 讀成 JSON,只要有任何資源的 actions 包含 delete,就會失敗。Terraform 的 JSON 格式會把替換寫成 ["delete", "create"] 或 ["create", "delete"]。官方說明文件寫明,採用這種形式,就是為了讓呼叫端只要搜尋 delete,就能抓到三種會刪除資源的情況:
["delete"]:只刪除資源。["delete", "create"]:替換資源,先刪除舊的再建立新的,這是 Terraform 的預設做法。["create", "delete"]:替換資源,先建立新的再刪除舊的,用於設定了create_before_destroy的資源。
workflow 裡的檢查是這樣寫的:
- name: terraform plan  run: terraform -chdir="$TF_DIR" plan -input=false -no-color -lock-timeout=10m -out=tfplan
- name: Refuse deletes and replacements  run: |    terraform -chdir="$TF_DIR" show -json tfplan > plan.json    jq -r '.resource_changes[] | select(.change.actions | index("delete")) | "\(.change.actions | join("/")) \(.address)"' plan.json > destructive.txt    if [ -s destructive.txt ]; then      echo "::error::refusing to apply a plan that deletes or replaces resources"      cat destructive.txt      exit 1    fi
- name: terraform apply  run: terraform -chdir="$TF_DIR" apply -input=false -no-color -lock-timeout=10m tfplan
套用 tfplan 而不是重新執行 plan,代表變更的只會是通過檢查的那份 plan 裡列出的資源。如果在 plan 和套用之間 state 有了變動,Terraform 會拒絕套用這份已經過時的 plan。
我把負責建立 state bucket 和兩個 GitHub role 的 bootstrap root,改寫成共用模組 modules/bootstrap。把測試帳戶的資源搬進這個模組,用了 13 個 moved 區塊。moved 區塊會告訴 Terraform,資源只是換了位址,並不是換成了另一個資源。測試帳戶的 bootstrap 因此規劃出 0 to add, 0 to change, 0 to destroy,production 的 bootstrap 則新建立了 13 個資源。
第一次套用 production 時卡在了兩個 OpenSearch security policy
第一次執行匯入了全部 45 個資源並套用了大部分的更新,但是在 OpenSearch Serverless 的兩個 security policy 上失敗了:
Error: updating OpenSearch Serverless Security Policy
  with module.data_layer.aws_opensearchserverless_security_policy.encryption,  on ../../modules/data-layer/opensearch.tf line 10, in resource "aws_opensearchserverless_security_policy" "encryption":  10: resource "aws_opensearchserverless_security_policy" "encryption" {
ID: <collection-name>Cause: operation error OpenSearchServerless: UpdateSecurityPolicy, ,ValidationException: No changes detected in policy or policy description"
這是因為主控台替這兩個 policy 都填了描述(description 欄位),模組卻沒有宣告任何描述。於是 Terraform 送出了一個更新把描述清空,policy 本身則沒有改變。OpenSearch Serverless 的 UpdateSecurityPolicy API 認為這個請求沒有任何變更,因此拒絕了它。更新不算刪除,所以刪除檢查放行了這份 plan。
沒有任何東西被刪除,已經成功的部分也都保留了下來。Terraform 是以資源為單位套用的。role、security group 規則、Glue 資料表和 Lambda 的更新都已經完成,依賴 OpenSearch Serverless collection 的資源則還沒有開始套用。
我不再讓 Terraform 管理這些描述,範圍包括這兩個 policy,以及主控台同樣填了描述的 collection:
resource "aws_opensearchserverless_security_policy" "encryption" {  name   = local.collection_name  type   = "encryption"  policy = jsonencode({ /* 規則與金鑰設定,此處省略 */ })
  # 主控台填了描述;把它清空的更新會被 UpdateSecurityPolicy API 拒絕。  lifecycle {    ignore_changes = [description]  }}
pull request 的 production plan 列出了剩下的變更,第二次執行把它們套用完成:
Apply complete! Resources: 5 added, 3 changed, 0 destroyed.第二次套用完成後,再執行 plan 就輸出了 No changes. Your infrastructure matches the configuration.。
總結
production 和測試帳戶現在使用同一個資料層模組,production 只有在我手動啟動 workflow 時才會套用。在對 production 做任何變更之前,唯讀的 plan(import 區塊、本機 state 的覆寫檔案、唯讀的憑證)就先顯示了接管會造成的 7 個替換。
主控台建立資源時,會用自己的方式替資源命名,所以我讓模組把這些名稱當作輸入,而不是把資源改名。原本從另一個資源的名稱組出來的名稱,我改成給它一個自己的固定值。這樣一來,替某個資源改名,就不會導致另一個資源被替換。
production 沒有設定審查者,而是靠刪除檢查把關。只要存下的 plan 裡有任何資源會被刪除,就不會套用。
不過刪除檢查只看刪除,抓不到像這次 security policy 那樣到套用時才失敗的更新。所以主控台填過、API 又不允許清空的欄位(例如描述),我都放進了 ignore_changes,讓 Terraform 不去更新它們。