AstroブログをGoogleとChatGPTに見つけてもらう — robots.txt・JSON-LD・プレーンテキスト版・IndexNow
AstroブログをGoogleとBingに載せた方法。AIクローラーを名指しするrobots.txt、headに置いたJSON-LD、記事のプレーンテキスト版、デプロイごとのIndexNow送信を紹介します。
目次
はじめに
自分の記事のタイトルをそのままGoogleで検索したところ、何も返ってきませんでした。ブログは3言語で何か月も公開していたのに、Googleのインデックスには1本も載っていませんでした。
最初に疑ったのはoharu-tech-blog.vercel.appというホストです。実際の原因はもっと地味でした。サイトはどの検索エンジンにも登録されておらず、被リンクもなく、/robots.txtは404を返していました。
それを直すうちに、もう1つ疑問が出てきました。ChatGPTやClaudeは、何をもとに引用するページを選んでいるのでしょうか。答えはBingとBraveの検索インデックスで、ほとんど取得されていないllms.txtではありません。
今のブログは、robots.txtでAIクローラーを1つずつ名指しし、各記事をHTMLページと並べてMarkdownでも配信し、デプロイのたびに新しいページをBingへ知らせています。
Googleはvercel.appのホストのクロール頻度を抑えるが、クロール自体はする
*.vercel.appは非常に多くのプロジェクトが使う共有サブドメインで、その中にはスパムも含まれます。そのため検索エンジンは、これをまとめてレート制限し、優先度を下げます。さらにSearch Consoleではドメインプロパティとして登録できず、URLプレフィックスとしてしか登録できません。
これで抑えられるのは検索順位です。評価の低いホストにあるサイトでも、クロール自体はされます。私のブログがインデックスにまったく載っていないことは、ホストでは説明がつきませんでした。検索エンジンが新しいサイトを見つける方法は、主に次の2つです。
- 他のサイトからのリンクをたどる
- 誰かが送信したそのサイトのサイトマップを読む
私のブログにはどちらもなく、Googleには見つけようがありませんでした。
検索での見つかりやすさ(SEO)に影響する問題を、影響の大きい順にまとめました。
| 問題 | 影響 |
|---|---|
| Search ConsoleにもBingにもサイトマップを送信しておらず、他サイトからの被リンクもない | Googleがサイトを見つける手段がない |
*.vercel.appの共有サブドメイン | 検索エンジンにクロール頻度を抑えられ、順位も上がりにくい |
/robots.txtが404を返す | 何もブロックしないが、クローラーにサイトマップの場所が伝わらず、AIクローラー向けのポリシーもない |
hreflangとcanonicalが別のURLを指す | 各記事の多言語版の対応をGoogleが無視しうる |
全ページが静的HTMLで、X-Robots-Tagもありませんでした。sitemap-index.xmlは3ロケールすべてを含めて200を返し、各記事にはすでにBlogPostingのノードがありました。つまりこのブログはずっとクロールできる状態で、私がその存在をクローラーに知らせていなかっただけです。
robots.txtがなくても、何もブロックされません。ファイルがなければ「すべてクロールしてよい」という意味になるからです。失うのは、やって来たクローラーにサイトマップの場所を教えるSitemap:行と、AIクローラーに対する方針の記載です。
検索エンジン向け: hreflang、ドメイン、Search Console
hreflangとcanonicalが別のURLを指していた理由
canonicalタグ(<link rel="canonical">)は、そのページの正式なURLを1つだけ宣言するタグです。検索エンジンがインデックスするのはこの正式なURLだけです。同じページに2つ以上のURLがある場合、それ以外のURLは複製として扱われ、インデックスされません。
src/i18n/config.tsのlocaleUrl()は、ナビゲーション、hreflang、RSSフィードのパスを組み立てる関数で、末尾にスラッシュを付けずに返していました。一方、canonicalタグとog:urlはAstro.url.pathnameから作られます。静的ビルドは各ページをフォルダ内のindex.html(例:blog/x/index.html)として出力し、フォルダのURLは/blog/x/になるので、Astro.url.pathnameはスラッシュで終わります。
その結果、3言語すべての全記事に、スラッシュありとなしの2つのURLが混在していました。
<link rel="canonical" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/"><link rel="alternate" hreflang="en-US" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search">スラッシュなしのURLは、同じページの2つ目のコピーでした。Vercelはどちらのパスにも同じHTMLを200で返し、canonicalタグが指すのはスラッシュ付きのほうだけです。
Googleはhreflangをヒントとして扱い、canonicalではないURLを指すhreflangは無視することがあります。つまり全記事の言語版の対応がGoogleに捨てられるおそれがあり、日本語で検索した読者に英語版の記事が表示されかねませんでした。
私はlocaleUrlを、常にスラッシュを付けるように変えました。これでlocaleUrl()とAstro.url.pathnameが作るURLが揃います。例外はパスの最後のセグメントにドットを含む場合だけで、/rss.xmlや/blog/<slug>.mdの拡張子を残すためです。
export function localeUrl(locale: Locale, path = "/"): string { const suffix = path.startsWith("/") ? path : `/${path}`; const isFile = suffix.slice(suffix.lastIndexOf("/") + 1).includes("."); const normalized = isFile || suffix.endsWith("/") ? suffix : `${suffix}/`; return `${localePrefix(locale)}${normalized}`;}再ビルド後は、canonicalとhreflangの2つのタグが同じURLを指し、ナビゲーションのリンクもすべてcanonicalのURLを指すようになりました。
<link rel="canonical" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/"><link rel="alternate" hreflang="en-US" href="https://oharu121.com/blog/rag-vs-finetuning-kb-search/">サイトマップは各URLにlastmod(そのページの最終更新日)を付け、どのページを再取得すべきかをクローラーに伝えます。scripts/lib/article-lastmod.tsはこの日付をURLをキーにして持っていて、以前は自前でスラッシュを足していました。localeUrlがスラッシュを付けるようになった今、さらに足すとキーが//で終わり、サイトマップのどの<loc>(各エントリのURL)とも一致しなくなります。そうなるとエラーも出ないまま全記事のlastmodが消えてしまうので、私はこのスクリプトをlocaleUrlの出力をそのまま使うように変えました。
Cloudflareをプロキシなしで使ってoharu121.comへ移す
最初に選んだのは年3ドルの.clickドメインでしたが、エージェントが反対しました。安価な新しいTLDに直接の順位ペナルティはありません。ただしスパム目的の登録が非常に多く、インデックスされるのが遅くなり、リンクもされにくくなります。そこで私はoharu121.comを買いました。
blog.oharu121.comやwww.oharu121.comのようなサブドメインではなく、apexをそのまま使うことにしました。apexを使う別のサイトは今のところないので、apexを空けたままブログをサブドメインに置く意味がありません。www.oharu121.comは308でapexへリダイレクトします。
私はDNSをCloudflareのままにし、プロキシ(トラフィックをまずCloudflareのサーバーに通す機能)は今後もずっとオフにしました。Vercelがすでに自前のエッジネットワークからサイトを配信しているので、プロキシを入れるとCDNが二重になり、デプロイ後も古いHTMLが返る可能性があります。
もう1つの理由として、CloudflareのボットとAIクローラー向けのルールは、プロキシを通るトラフィックにしか作用しません。新しく追加したドメインには、エージェント型クローラーをブロックしたり、学習拒否の意思表示を送ったりするプリセットが適用されます。これは後述するrobots.txtの許可リストを上書きしてしまいます。DNSのみのレコードにしておけば、クローラー方針はrobots.txtだけで決まります。
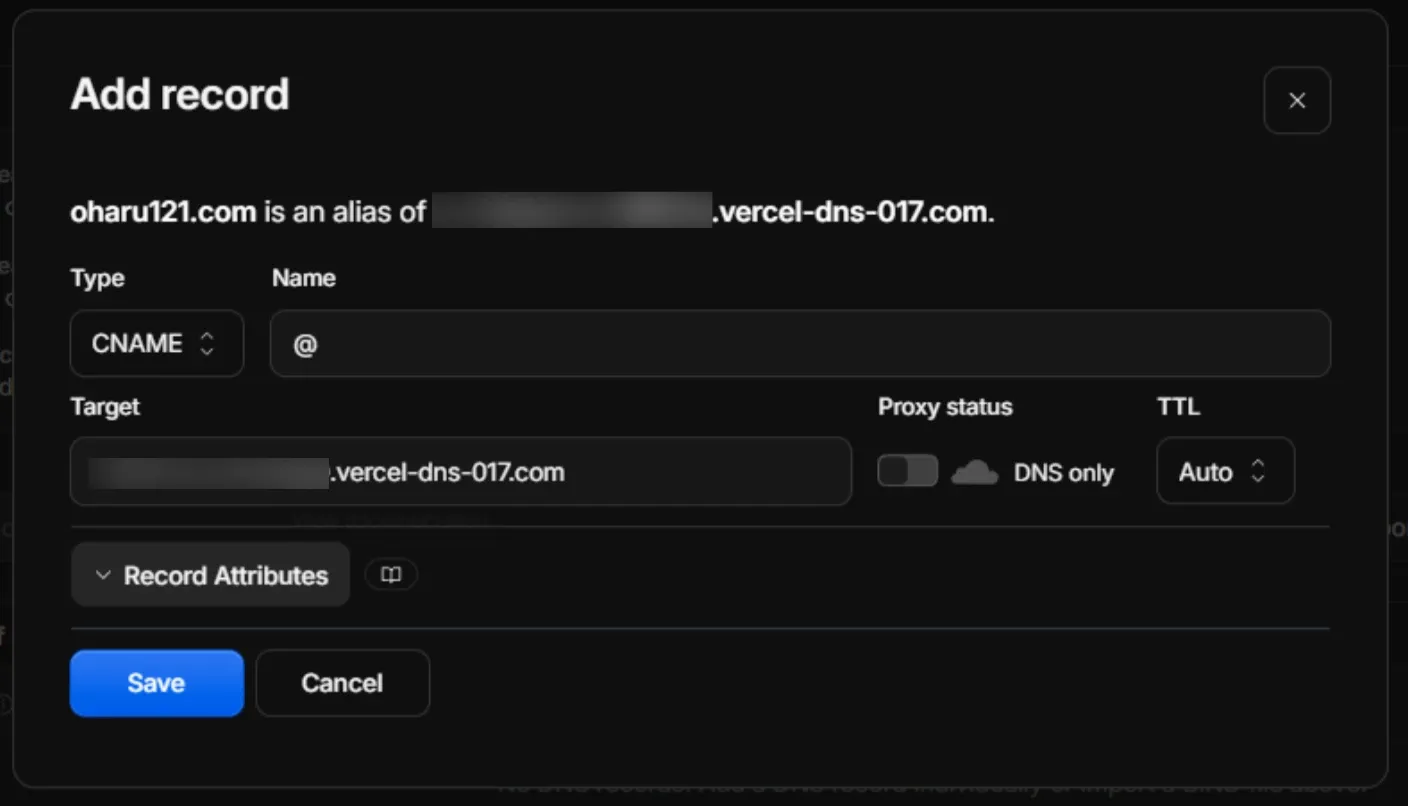
CNAMEでapexをVercelに向ける
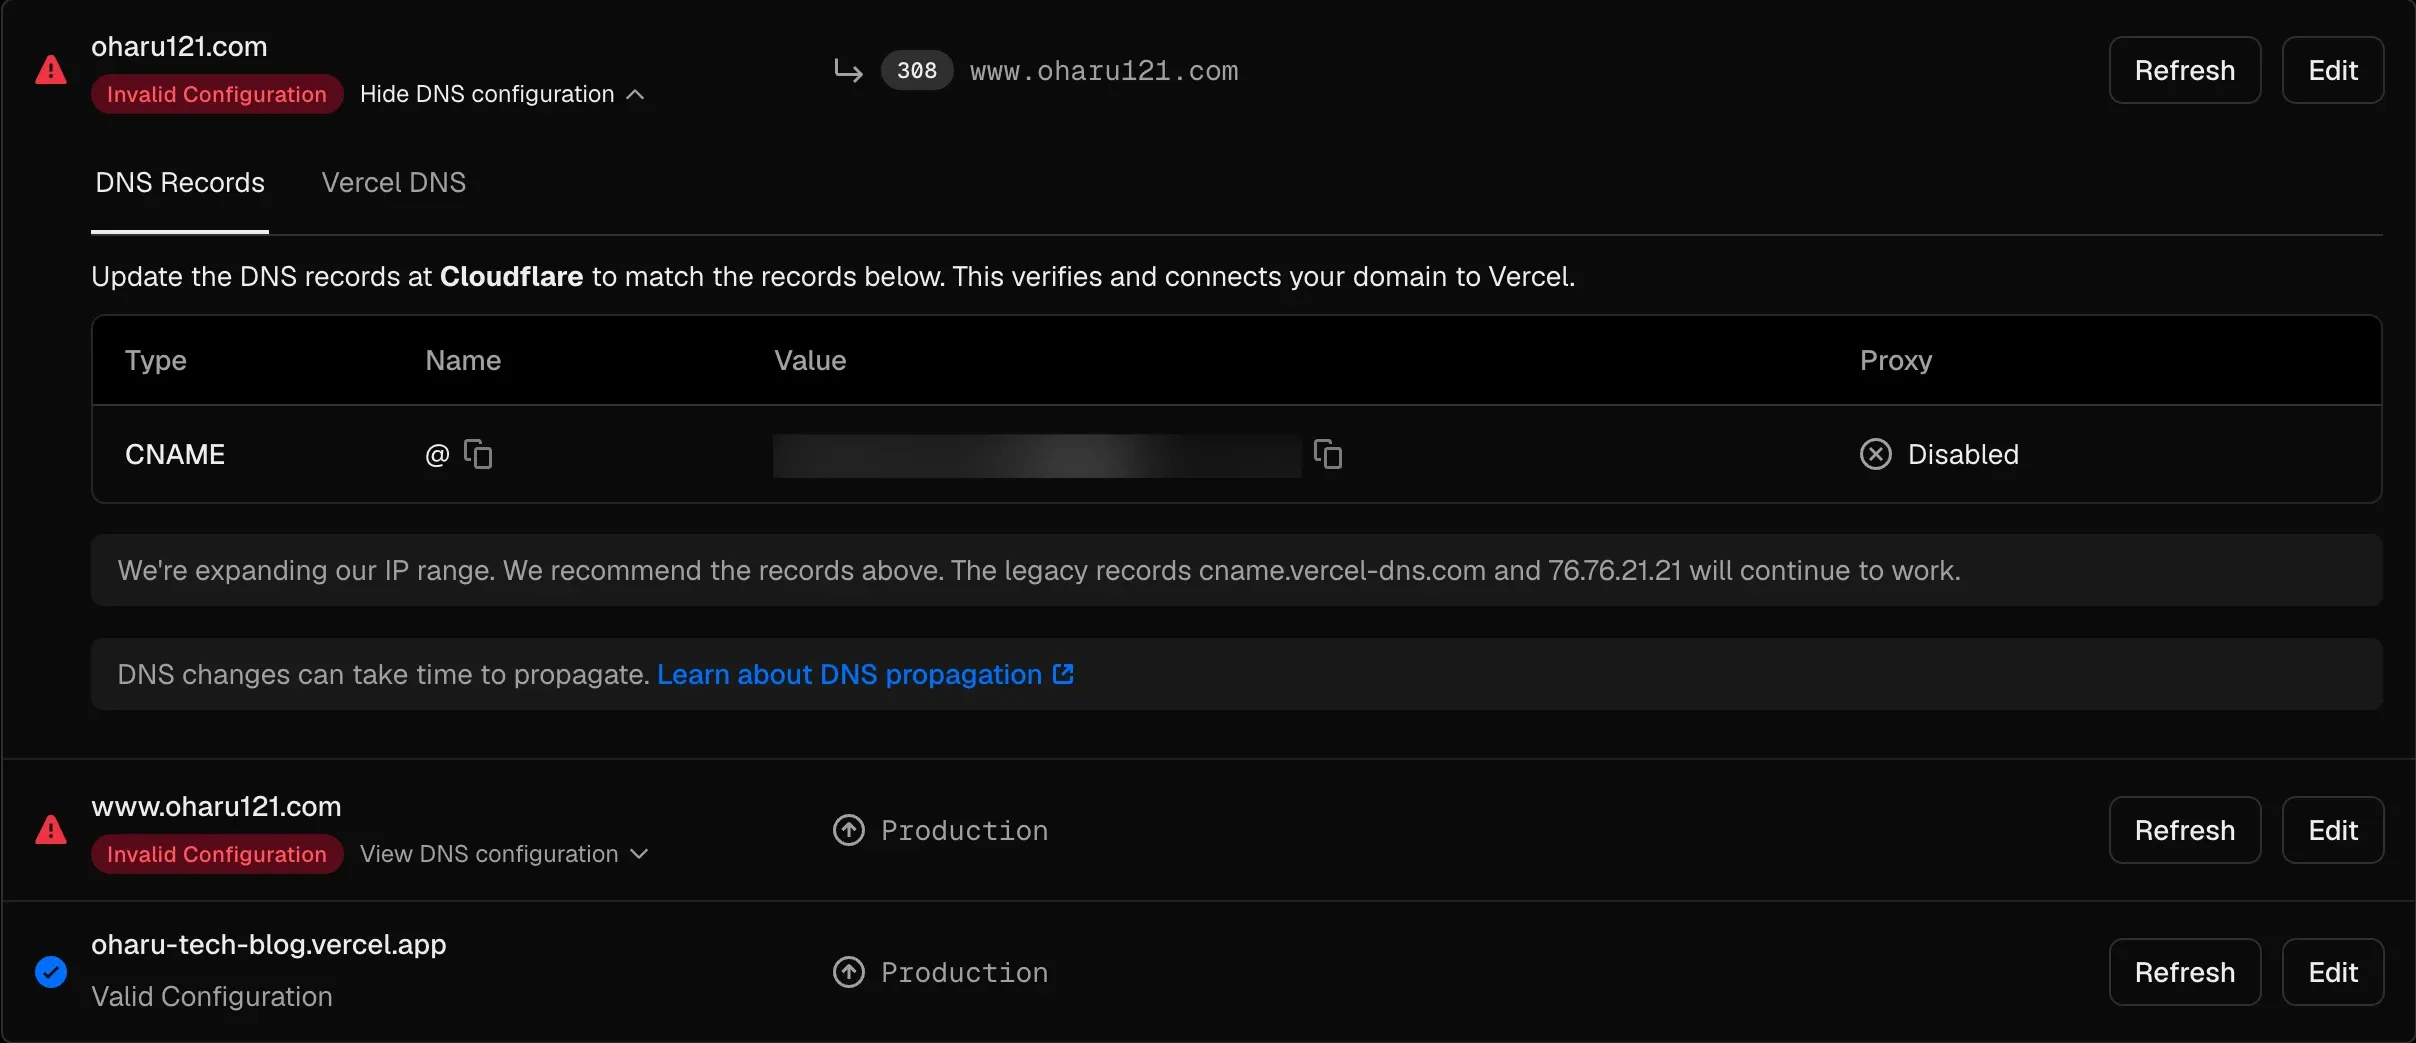
Vercelがapexに求めたのは、多くのガイドが今も載せている汎用のcname.vercel-dns.comではなく、プロジェクトごとのホスト名を指すCNAMEレコードでした。
CNAMEレコードは、ある名前を別の名前の別名にするレコードです。oharu121.comを問い合わせると「これはxxxx.vercel-dns-017.comの別名です」と返され、Vercelがこのプロジェクト用に発行したそのホスト名を改めて問い合わせて、IPアドレスを得ます。Aレコードは名前を1つの固定IPアドレスに結びつけるので、IPが変わるたびに書き換えが必要です。CNAMEなら、ターゲットを最新のIPに対応づけるのはVercelの役目なので、私の側では何も変える必要がありません。
ただし、DNSの規則はapexへのCNAMEを禁じています。apexにはNSレコード(そのドメインの問い合わせに答えるサーバー)とSOAレコード(ドメインの管理情報)が必ず必要で、「この名前のすべてを別の名前に委ねる」というCNAMEは、この2つと衝突します。
それでも動くのは、CloudflareがこのCNAMEを外に送らないからです。CNAMEフラット化(CNAME flattening)はDNSの標準ではなくCloudflare独自の機能で、CNAMEのターゲットのIPを自分で引いて通常のAレコードとして応答します。この機能がないDNSプロバイダー向けに、VercelのナレッジベースはapexにAレコード76.76.21.21を勧めています。Vercelの設定画面にも、このAレコードが引き続き使えると書かれています。
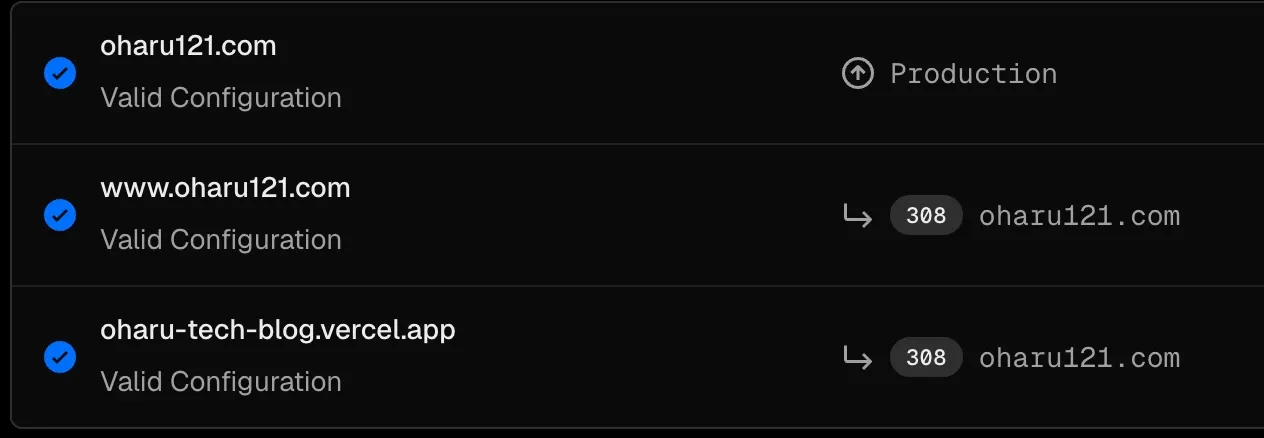
旧ホストは、どのパスにも新ドメインの同じパスへの308(恒久的なリダイレクト)を返します。たとえば旧ホストの/blog/x/は、新ドメインの/blog/x/へリダイレクトされます。リダイレクトをたどるクローラーは旧ページを一切読まないので、canonicalタグよりも確実に2つのホストが1つにまとまります。
コード側では、1行変えるだけで移行が済みました。robots.txtのSitemap:行、サイトマップ、RSS、llms.txt、canonicalタグ、IndexNowのスクリプトを含め、サイト上のすべての絶対URLは1つの定数SITEから組み立てられています。
export const SITE = "https://oharu121.com";Search Consoleにドメインプロパティを登録する
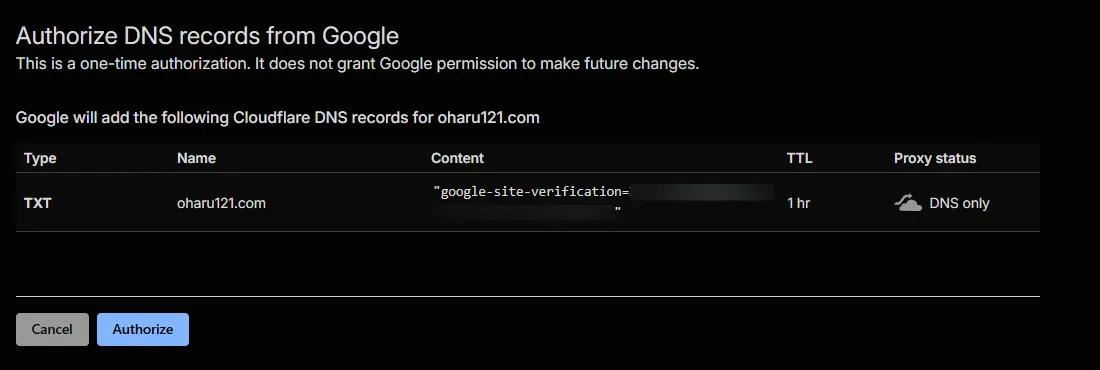
Search ConsoleのドメインプロパティはDNSのTXTレコードで検証し、apex、www、HTTPとHTTPS、将来のサブドメインまでまとめてカバーします。GoogleとCloudflareには、そのレコードを代わりに書いてくれる1回限りの認可フローがあります。
最初はサイトマップをsitemap-index.xmlというパスだけで送信し、「Invalid sitemap address. Please enter a valid path to a sitemap in your site.」で拒否されました。完全なURLを入力する必要があります:https://oharu121.com/sitemap-index.xml。
私はBing Webmaster Toolsに、Search Consoleから検証とサイトマップを取り込みました。そのためBing側でサイトを検証したり、サイトマップを送信したりする必要はありませんでした。
回答エンジン向け: robots.txt、llms.txt、JSON-LD、プレーンテキスト版、IndexNow、Brave
robots.txtで11のAIクローラーを名指しする
robots.txtは今、src/pages/robots.txt.tsというルートで生成しています。そのためSitemap:行は定数SITEから組み立てられ、ドメインを移しても追従します。方針は私が決めました。学習データを集めるものも含めて、AIクローラーはすべて許可します。このブログの目的は多くの人に届くことで、学習コーパスも、ここに書いた考えが読まれる場所の1つです。
User-agent: *とAllow: /ですでにすべてのクローラーがサイト全体を取得できますが、私は11すべてを名前で列挙し、クローラーごとに個別のスイッチを持たせました。
# OpenAI — training data for future modelsUser-agent: GPTBotAllow: /
# OpenAI — the index behind ChatGPT searchUser-agent: OAI-SearchBotAllow: /学習と検索は別のクローラーで、スイッチも別々です。1つをブロックしても、他のクローラーは動き続けます。Anthropicはドキュメントで3つのクローラーを挙げています。
ClaudeBot:学習データを集めるClaude-SearchBot:検索インデックスを作るClaude-User:利用者が求めたページを取得する
クローラーを1つずつ名指ししておけば、1行をDisallowに変えるだけで方針を変えられます。回答で引用はされたいが学習には使われたくないサイトなら、学習用のクローラーだけをブロックします。
ChatGPT-UserとClaude-Userはどちらも、利用者が求めたページを取得するクローラーですが、robots.txtの扱いは2社で異なります。OpenAIのドキュメントには「ユーザーが開始した操作なので、robots.txtのルールは適用されない場合がある」(拙訳)とあり、ChatGPT-UserへのDisallowはお願いにとどまります。一方、Anthropicのドキュメントは、Claude-Userを含む自社のすべてのボットがrobots.txtに従うとしています。
3社の8つのクローラーは次のとおりで、どれもrobots.txtで個別に切り替えられます。
| 提供元 | 学習 | 検索インデックス | ユーザー起点 |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User(robots.txtが適用されない場合あり) |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | 非公開 | PerplexityBot | Perplexity-User |
llms.txtを読んでいるものはあるのか
llms.txtはMarkdownで書いたサイトのインデックスで、サイトのルートの/llms.txtに置きますが、読んでいるクローラーはほとんどありません。Limyの計測では、90日間で llms.txtへのリクエストはおよそ408件、同じ期間のAIボットの訪問は5億回超でした。本番環境でこのファイルを読むと表明した主要AIベンダーはありません。
ファイルを置くサイトは多いのに、読むクローラーはほとんどありません。Rankabilityの調査では、Tranco(よく使われる人気サイトのランキング)上位1,000サイトの約8.7%がllms.txtを置いていて、開発者向けサイトの多い一部のサンプルでは、その割合が半数を超えます。
ただ、IDEのエージェントやMCPサーバーは実際にllms.txtを取得しますし、このブログの読者は開発者です。そこで私はllms.txtを小さなインデックスとして、RSSフィードと同じ作りでロケールごとに1つ用意しました。
JSON-LDを<head>に移し、@idでつなぐ
各記事には以前からBlogPostingのノードがありましたが、<body>に出力され、publisher、url、keywordsもありませんでした。私はJSON-LDをsrc/lib/schema.tsで組み立てて<head>に置くように変え、記事にはBreadcrumbListを、一覧ページにはWebSite、Blog、ItemListを出力しています。
たとえば、ある記事の<head>にあるJSON-LDを抜粋すると次のとおりです。
{ "@type": "BlogPosting", "headline": "RAG vs fine-tuning for KB search — …", "url": "https://oharu121.com/blog/rag-vs-finetuning-kb-search/", "datePublished": "2026-08-11T15:07:58+09:00", "inLanguage": "en-US", "author": { "@type": "Person", "@id": "https://oharu121.com/#person", "name": "oharu" }, "isPartOf": { "@id": "https://oharu121.com/#website" }, "keywords": "RAG, LLM, Generative AI, Machine Learning"}どのページも、著者ノードとサイトノードを固定の@idで参照します。@idは、サイトのURLの後ろに#personや#websiteのようなフラグメントを付けたものです。
const personId = (site: URL) => new URL("#person", site).href;const websiteId = (site: URL) => new URL("#website", site).href;これで、クローラーがこのブログのどのページを何ページ読んでも、同名の複数人ではなく1人の著者として扱います。
シリアライザーは<をすべて\u003cにエスケープします。JSON.stringifyは</script>をそのまま残すので、それを含む文字列があるとタグが途中で閉じ、残りのJSON-LDがマークアップとしてページに漏れ出します。
WebSiteノードにはSearchActionを付けていません。このプロパティは、もともとGoogleの検索結果にサイトリンク検索ボックスを出すためのものでしたが、Googleは2024年11月にこの機能を廃止しました。しかもこのブログの検索ページは?q=パラメーターを読まないので、付けても使えない検索URLを宣言するだけです。
Search ConsoleのURL検査は、このパンくずのノードを読み取って表示します。
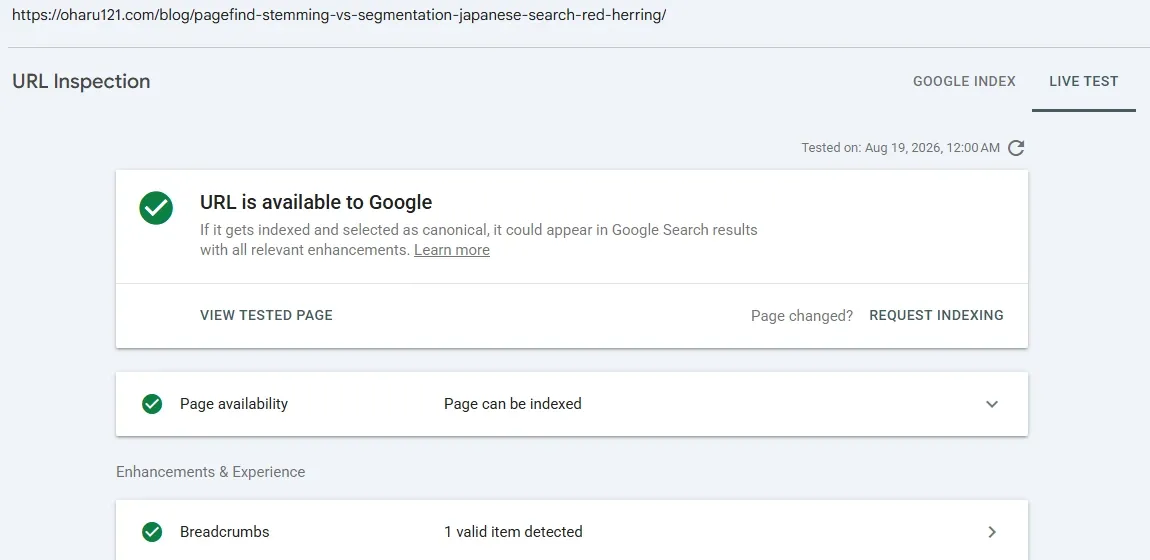
schema.tsが出力したBreadcrumbListのノードを、Googleが報告している。すべての記事をMarkdownでも配信する
各記事のURLの末尾に.mdを付けると、たとえば/blog/<slug>.mdのように、その記事のMarkdownのプレーンテキスト版が手に入ります。記事の<head>も<link rel="alternate" type="text/markdown">でこの版を指しています。これで回答エンジンは、HTMLページを解析しなくても本文を直接受け取れます。
このブログの記事はどれもコンポーネントをimportしていますが、Astroコンポーネントに相当するMarkdownはありません。src/lib/mdx-to-markdown.tsは、それぞれを次のようにテキストへ変えます。
- import文を取り除く。
<Callout>をラベル付きの引用ブロックにする。<Figure>を、キャプションと図版名に置き換える。- ラスター画像は代替テキストを残し、URLを落とす。ビルド後のアセットパスは変換処理には分からないコンテンツハッシュで、404になるリンクをモデルが引用すると、そのまま広まってしまう。
import Callout from '@/components/article/Callout.astro';import Figure from '@/components/article/Figure.astro';import RagVsFinetuning from './_figures/RagVsFinetuning.astro';
<Callout type="know">Fine-tuning changes behaviour, not facts.</Callout>
<Figure> <RagVsFinetuning /> <Fragment slot="caption">RAG keeps facts outside the model.</Fragment></Figure>
> **ちなみに**>> Fine-tuning changes behaviour, not facts.
*Figure — RagVsFinetuning: RAG keeps facts outside the model.*
*Image: A bar chart of answer accuracy*本文、見出し、表、コードフェンスは変更せずに通します。引用される内容は、ほぼすべてそこにあります。
IndexNowでデプロイのたびにBingのインデックスへ送信する
BingのインデックスはChatGPT検索の引用元の1つですが、その割合については見解が割れています。Seer Interactiveは2025年2月、100件のクエリで、SearchGPTの引用の87%がBingの上位結果と一致したと報告しました。2026年4月に400件のクエリで行われた追試では27%でした。いずれにしても、Bingがクロールしていないページは、Bing経由では引用されません。
IndexNowは、サイトから検索エンジンへ「これらのURLが更新された」と通知するためのプロトコルです。api.indexnow.orgという1つのエンドポイントにURLを送るだけで、Bing、Yandex、Seznam、Naverなどにまとめて通知できます。GoogleはIndexNowに参加していないので、Google側は引き続きSearch Consoleで別に対応する必要があります。
IndexNowは、URLを送信する人がそのサイトを管理しているかどうかを、キーファイルで確かめます。キーファイルはサイトのルートに置くファイルで、ファイル名がキーそのもの、中身も同じキーです。検証はこのファイルを「取得して照合する」だけです。私はこのファイルをpublic/にコミットし、scripts/indexnow.tsも同じファイルから読み込むようにしました。これで、送信するキーと配信しているキーが常に一致します。
buildLastmodMapは、サイトマップのために公開記事のURLとlastmodの一覧をすでに作っています。スクリプトはgitの差分を取らず、この一覧を日付の範囲で絞り込みます。
70 URL(s) for oharu121.com: …IndexNow accepted the batch (200).私は本番デプロイのたびにCIでpnpm indexnowを実行するようにしました。初回は202が返りました。受領済みでキーの検証は保留中、という意味です。その後の実行では200が返っています。
その後、BingのURL検査には赤いバツ印が出ました。
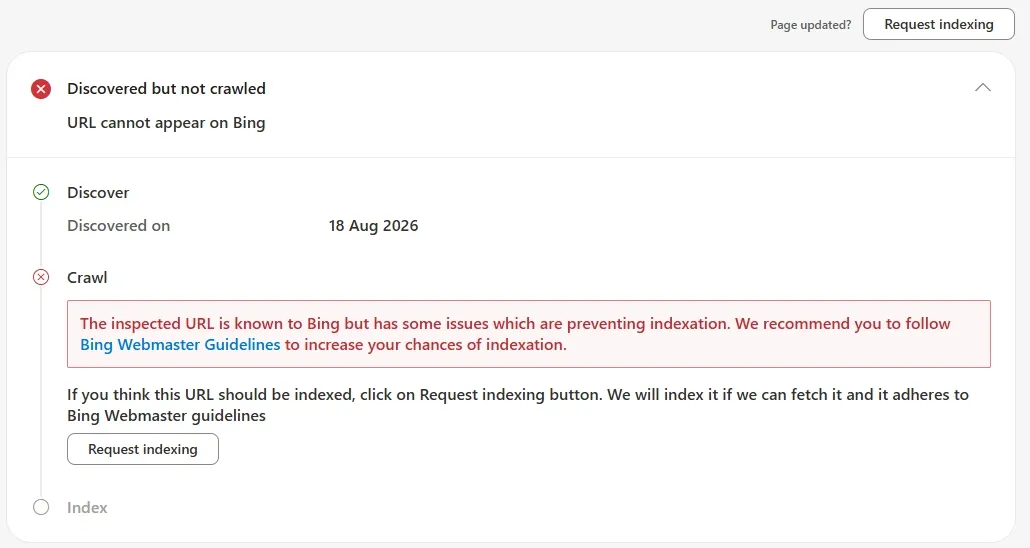
「Discovered but not crawled」は、ページがBingのクロール待ちに入っているという意味です。画面のDiscovered on 18 Aug 2026は、IndexNowでURLを送信した日です。公開から数日で被リンクもないドメインには、クロール予算(検索エンジンがそのサイトから取得してもよいと考えるページ数)がほとんどありません。IndexNowはURLの存在をBingに伝えますが、いつ取得するかを決めるのはBingです。
Claudeのウェブ検索が使うBraveは、送信を受け付けない
Claudeのウェブ検索は、ほぼ確実にBrave Searchを使っています。Anthropicは検索の提供元を明かしていません。ただ、Simon Willisonが気づいたとおり、Claudeのウェブ検索が公開される前日の2025年3月19日に、AnthropicはBraveをウェブ検索のサブプロセッサー(Anthropicに代わってデータを処理する外部の事業者)として登録しています。さらに、Claudeの引用はBraveの上位結果と一致します。
Braveにはウェブマスター向けのコンソールがなく、サイトマップも受け付けず、IndexNowにも参加していません。MERJの分析によると、Braveのクローラーは独自のユーザーエージェントを名乗らず、robots.txtがGooglebotに向けて書いたルールに従います。このブログはUser-agent: *ですべてのクローラーを許可しているので、Braveのクローラーもすでにクロールできる状態です。
Braveが新しいページを見つける主な手がかりは、GoogleとBingでの順位です。もう1つの情報源は、Web Discovery Projectに参加したBraveブラウザーの利用者で、自分が訪れたページを報告します。search.brave.com/submit-urlは、Braveがすでに知っているページの再取得を頼むだけで、新しいURLの送信には使えません。
まとめ
- Googleに載っていなかったのは、一度も登録しておらず、被リンクもなかったからです。
- 共有の
*.vercel.appホストは検索順位を抑えますが、Googleはクロール自体はします。 llms.txtが取得されたのは、ある計測でAIボットの訪問5億回に対してわずか408回ほどでした。このブログでは、IDEのエージェント向けの小さなインデックスとして置いています。- IndexNowはデプロイのたびにBingのインデックスへ送信します。BingはChatGPT検索の引用元の1つです。
- Claudeのウェブ検索はBraveを使います。Braveは送信を受け付けず、主にGoogleとBingでの順位からページを見つけます。
- 各記事のプレーンテキスト版は、ナビゲーションなどの周辺要素を取り除いた本文を回答エンジンに渡します。
参考リンク
- Google Search Consoleのサイトマップレポート。ドメインプロパティとURLプレフィックスプロパティの違いを含む
- 末尾スラッシュの有無で別のURLとして扱われることを説明したGoogle Search Centralの「To slash or not to slash」
- OpenAIのクローラードキュメント。GPTBot・OAI-SearchBot・ChatGPT-Userと、ユーザー起点の取得に対するrobots.txtの注意書き
- Anthropicのクローラードキュメント。ClaudeBot・Claude-SearchBot・Claude-Userを個別に拒否できる仕組み
- Limyのllms.txtガイド。5億回のAIボット訪問に対する408件のリクエスト
- RankabilityによるTranco上位1,000サイトのllms.txt導入状況
- Seer InteractiveによるSearchGPTの引用とBing・Googleの検索結果の比較
- BingとChatGPTの引用の重なりを400件のクエリで追試した記事
- Claudeのウェブ検索公開の前日、AnthropicのサブプロセッサーにBrave Searchが加わったことを指摘したSimon Willisonの記事
- Brave Searchがページを見つける仕組みを分析したMERJの記事。Googlebot向けルールに従うというBraveのクローラー説明を引用
- 新規ドメイン向けAIクローラープリセットに関するCloudflareの発表
- CloudflareのCNAMEフラット化のドキュメント。apexのCNAMEをAレコードとして応答する仕組み
- VercelのAレコードでドメインを向けるガイド
- IndexNowプロトコルの仕様。キーファイルの要件とレスポンスコードを含む
- vercel.appのURLとカスタムドメインの重複コンテンツを避けるためのVercelのガイド