AstroのService Workerで読んだ記事をオフラインでも開けるようにする — 205KBのシェルと記事50件の上限
AstroブログのService Workerで、サイト共通のCSSとJS 205KBを事前キャッシュします。記事は読んだ分だけ50件まで保持し、図版スタイルは必要になった時点でキャッシュします。
目次
はじめに
私は調べ物をするとき、よく自分の記事を読み返します。それがネットにつながらない機内ということも珍しくありません。一度読んだ記事なら、Wi-Fiを切ったままでも開けるようにしたいと考えました。
最初に思いついたのは本文を localStorage に入れておく方法で、作り始める前に Claude Code に可能かどうか聞いてみました。答えは無理でした。オフラインでURLを開くと、ブラウザはネットワークに取りに行き、そのまま「インターネットに接続されていません」の画面になります。localStorage に保存した文字列はページが読み込まれて初めて使えますが、そのページ自体が読み込めません。
うまくいったのはService Workerです。サイト共通のCSSとJSからなる205KBのシェルを事前キャッシュし、記事は読んだ時点で1件ずつ、50件まで保持します。一度インストールすれば、読者が開いたページがそのままオフラインで読める記事になり、シェルのほかに余分なダウンロードは発生しません。
最初の直感は外れた:localStorage はナビゲーションに応答できない
ブラウザはURLを取得するとき、HTTPキャッシュとネットワークだけを参照します。ページが自分で保存した文字列を、応答の候補として差し出す仕組みはどこにもありません。そのため localStorage に保存した本文には、必要になったその瞬間に手が届かないのです。
localStorage をページの保存先として使うには、ほかにも3つの制約があります。
- 容量は1オリジンあたりおよそ5MBで、このサイトの記事なら数十本分です。
- 保存できるのは文字列だけなので、文書はヘッダーもステータスもContent-Typeも持たないまま入ります。
- 同期的に動くので、大きなエントリを読み出すとメインスレッドが止まります。
Cache API は Request と Response の組を、ヘッダーとステータスごと保存します。ナビゲーションに応答するには、まさにこの形が必要です。Service Worker はネットワークの手前に立ち、どのページからも独立して動き、保存したレスポンスを返せます。
// ブラウザでナビゲーションに応答できるのは Service Worker だけ。self.addEventListener('fetch', (event) => { if (event.request.mode === 'navigate') { event.respondWith(handleNavigation(event)); }});ビルドの計測:記事のHTML、シェル、記事ごとのスタイル
図版がインラインSVGなので記事ページは317KBに達する
最初に浮かぶのは全ページの事前キャッシュですが、.vercel/output/static/ を計測するとその案は消えます。ビルドは1,819ファイルで73MBあります。
| 内訳 | サイズ | ファイル数 |
|---|---|---|
| 記事のHTML(3言語) | 22.6 MB | 179 |
| ホーム・アーカイブ・タグ・検索などのHTML | 8.3 MB | 217 |
_astro/ の画像 | 33.6 MB | 892 |
pagefind/ | 3.4 MB | 237 |
| Markdown の複製 | 3.0 MB | 179 |
_astro/ のCSSとJS | 0.39 MB | 94 |
| フィード・サイトマップ・アイコン・Webフォント | 2.1 MB | 21 |
| 合計 | 73.4 MB | 1,819 |
記事ページで最大のものは、HTMLだけで317KBあります。このサイトの図版はラベルを翻訳できるようにインラインSVGのコンポーネントにしているので、図はすべて文書の中に入ります。全ページを事前キャッシュすると、1ページを求めただけのスマートフォンに31MBのHTMLを送り込むことになります。
そこでシェルだけを事前キャッシュし、ページは読んだ時点でそのつど保持します。オフラインで読めるのは「すでに開いたものすべて」になり、機内で読み返すにはこれで足ります。ページを保持しても余分な通信は発生しません。そのレスポンスは、ページを描画するためにどのみち取得していたものだからです。
シェルにはすべてのページが読み込むものを入れる
シェルは43エントリで205KBです。内訳はスタイルシート20本、スクリプト14本、Webフォント、アイコン5点、3言語分のウェブアプリマニフェストです。CSSとJSのファイル名にはすべてコンテンツハッシュが付き、そのハッシュはビルドが終わるまで存在しません。そのため、この一覧は scripts/build-sw.ts がビルド時にワーカーへ書き込みます。
このスクリプトはビルドのたびにシェルのサイズを表示し、500KBの予算を超えると警告します。シェルは、すべての読者が初回訪問時にダウンロードします。つまりシェルのサイズ(現在は205KB)が、この設計で最初に払うコストです。
_astro/*.css をまとめて対象にすると全記事の図版スタイルが事前キャッシュされる
図版のコンポーネントはそれぞれスコープ付きのCSSを持ち、Astroはそれを _astro/ の下に別ファイルとして出力します。このサイトは inlineStylesheets: 'never' を設定し、style-src 'self' のContent Security Policyがすべてのスタイルシートに効くようにしています。理由はCSPの記事で説明しています。
そのため _astro/ の下にあるCSSとJSをすべてシェルに入れると、サイト上の全記事の図版スタイルまで事前キャッシュされます。ある記事に図版が3点増えたところで、予算の警告が出ました。
入力node scripts/build-sw.ts出力sw.js: version 93b802612533, 103 shell entries (503.1KB), 3 offline pages shell is 503.1KB, over the 500.0KB budget in scripts/build-sw.ts. Every reader downloads this on their first visit — check what got included.1記事の図版だけが使うスタイルは、94チャンクのうち60個、299KBを占めていました。これはチャンクの名前からは見分けられません。AstroはCSSチャンクに、その中の最初のコンポーネントの名前を付けるからです。実際、Pipeline.*.css は2つの別々の記事の図版です。
そこでスクリプトはビルド済みのHTMLをすべて読み、各チャンクをどのページがリンクしているかを記録します。確かな手がかりになるのは、ページが何をリンクしているかです。
| チャンク | リンク元 | シェルに入るか |
|---|---|---|
BaseLayout.*.css、29KB | すべてのページ | はい |
ArticleLayout.*.css、10KB | すべての記事 | はい |
pagefind-ime-guard.*.js | ページからはなし。検索のスクリプトが読み込む | はい |
IndexNowKey.*.css、7.3KB | 1記事(3言語すべて) | いいえ |
VanishingGradientTwoAxes.*.css、52KB | 1記事(3言語すべて) | いいえ |
シェルから外すのは、1つの記事だけが使い、ほかのページはどこも使わないチャンクだけです。たとえば IndexNowKey.*.css を読み込むのは IndexNow の記事だけなので外します。BaseLayout.*.css はすべてのページが読み込むので残します。
どのページのHTMLにも現れないチャンクもあります。ページではなく、スクリプトが読み込むからです。pagefind-ime-guard.*.js がその例で、すべてのページで検索スクリプトがこれをインポートします。HTMLを走査しても誰が使っているか分からないので、シェルに残します。これがないと、オフラインでは検索スクリプトが起動しません。
for (const page of files.filter((path) => path.endsWith(".html"))) {  const html = await readFile(join(OUT_DIR, page), "utf8");  const segments = page.split("/");  if (LOCALES.includes(segments[0])) segments.shift();  const owner =    segments.length === 3 && segments[0] === "blog" && segments[2] === "index.html"      ? `blog/${segments[1]}`      : "site";
  for (const [asset] of html.matchAll(/\/_astro\/[^"'\s)]+\.(?:css|js)/g)) {    const set = owners.get(asset) ?? new Set();    set.add(owner);    owners.set(asset, set);  }}// 所有者が1つの `blog/<slug>` だけのチャンクは、ランタイムキャッシュに任せる。
修正後の同じビルドです。
入力node scripts/build-sw.ts出力sw.js: version 4d9dcd1871d4, 43 shell entries (204.5KB), 3 offline pages 60 per-article chunks (298.6KB) left to runtime cachingシェルは205KBになり、新しい記事に図版を足してもシェルは増えません。Service Workerを作るためのGoogleのライブラリWorkboxも、公式ガイドで同じことを勧めています。すべてのページが必要とするものだけを事前キャッシュし、特定のページだけで使うチャンクはランタイムキャッシュに任せる、という考え方です。
データセーバーはブラウザが報告する環境でだけシェルを省く
サイトが黙って何かをダウンロードすることを読者は嫌がらないか、と私は以前に尋ねていました。205KB程度なら、同意ダイアログで読者の手を止めるほうが、ダウンロードそのものより負担が大きくなります。だから確認のダイアログは出しません。データセーバーを有効にした読者にもワーカーは入り、読んだものは保持されます。ただし、ページがワーカーにシェルの取得を頼むことはありません。
判定には navigator.connection?.saveData を使い、これが効くのはChromium系のブラウザだけです。MDNはNetwork Information APIを「Limited availability」(対応ブラウザが限られる)としており、SafariとFirefoxは saveData を実装していません。そうしたブラウザでは、データセーバーがオンかどうかをページから知る方法がありません。判定はエラーにならず undefined を返すだけで、コードはそれをオフとして扱います。そのため、通信量を節約したい読者にも205KBのシェルがダウンロードされます。
5つのキャッシュ:シェル、ページ、画像、アセット、オフラインページ
増え方については、私から3つ質問しました。読者がいる言語だけをキャッシュすべきか、エントリに期限を設けるべきか、上限を設けるべきか。答えは、はい・いいえ・はい、でした。
事前キャッシュするのは読者自身の言語のホームページだけ
ワーカーが事前キャッシュするのは、読んでいる言語のホームページだけで、ほかの言語のものは入れません。スタイルシートとスクリプトは3言語で共有しているので、2つ目の言語を足しても増えるのはホームページだけです。日本語を一度も開かない読者に、日本語のホームページは要りません。
有効期限の代わりに上限を設ける
Cache API には有効期限がなく、ワーカーもそれを自作しません。TTLを持たせるには、ページが古くなったかを推測するためだけに、タイムスタンプの表を別に保つ必要があります。経過時間で破棄すれば、読者が意図して残したページまで消えます。何が変わったかは、デプロイがすでに教えてくれます。デプロイのたびに新しいワーカーのバージョンが生まれ、ワーカーはそのバージョンに合わせてシェルを突き合わせ直します。
記事は訪問のたびにバックグラウンドで再検証します。一覧ページは先にネットワークを見ます。その理由は続編の記事で説明しています。
代わりに上限で増え方を抑えます。上限は計測した平均値から決めました。記事のHTMLは129KB、_astro の画像は39KB、記事ごとのスタイルチャンクは5KBです。
| キャッシュ | 保持するもの | 上限 | 上限時のサイズ |
|---|---|---|---|
oharu-pages | 読んだ記事のHTML | 50 | 約6.3 MB |
oharu-images | ページが描画した図版 | 200 | 約7.7 MB |
oharu-assets | 1記事だけが使うスタイル | 150 | 約0.8 MB |
oharu-shell | サイト共通のCSS・JS、フォント、アイコン、マニフェスト | 120 | 約0.6 MB |
oharu-offline | オフライン用ページ3枚 | 削除しない | 約100 KB |
破棄は挿入順のFIFOです。Cache API が公開している順序はこれしかありません。本当のLRU(Least Recently Used:いちばん長く開かれていないものから破棄する方式)にはアクセスを記録するテーブルを IndexedDB に別途持つ必要がありますが、おおむね時系列順に読まれるブログでは、どちらでも同じ結果になります。
記事ごとのスタイルには専用のキャッシュを用意する
記事の図版スタイルは、その記事が読み込んだ時点で oharu-assets に入ります。そのため一度オンラインで開いた記事は、オフラインでも図版を表示できます。ワーカーは事前キャッシュの一覧を見て振り分けます。
if (SHELL_ASSET.test(url.pathname)) { event.respondWith( SHELL_PATHS.has(url.pathname) ? cacheFirst(request, SHELL_CACHE, SHELL_CAP) : cacheFirst(request, ASSET_CACHE, ASSET_CAP), ); return;}2つのキャッシュは溜まり方が違います。シェルにはデプロイのたびに新しいハッシュのファイルが加わりますが、図版のチャンクは最初に読まれたときに1度だけ書き込まれます。1つのFIFO上限を共有すると、記事本体はまだ oharu-pages に残っているのに、デプロイが続くだけでその記事の図版スタイルが破棄されかねません。
上限150は、保持しているページ1件あたり3つ分です。1つの記事が読み込むこの種のチャンクは1つ程度なので、あるチャンクが破棄されるのは、異なるチャンクをおよそ150個読んだあとです。このサイトにそれほどの数はありません。
オフラインページは削除しない
オフラインページを専用のキャッシュに置くのは、どのエントリよりも先に書き込まれるうえ、FIFOは古いものから消していくからです。シェルに入れておけば真っ先に破棄される側になり、サイトを使い込むほどフォールバックが消えていきます。
オフラインページの言語はURLだけで決めます。/ja/… と /zh-tw/… はそのまま言語を示し、接頭辞のないパスは英語です。英語のページは src/pages/ の直下にあるからです。
function offlineLocaleFor(url) { const prefix = url.pathname.split('/')[1]; return LOCALES.includes(prefix) ? prefix : DEFAULT_LOCALE;}navigator.language は読みません。ここの読者には、ja-JP の環境で意図して英語を読んでいる人が少なくありません。英語のリンクに日本語の通知を返せば、その選択を覆すことになります。オフラインページにはサイトのヘッダーがそのまま付いています。URLの言語が望みと違っても、言語切り替えまではワンタップです。
テストの3つの落とし穴:DevToolsのオフラインモード、3xxのナビゲーション、アイコンのバイト列
DevToolsのオフラインモードではService Workerがオンラインのまま
Network.emulateNetworkConditions は設定したターゲットにだけ効き、Service Worker は配信先のページとは別の DevTools ターゲットです。Chrome DevTools を Network: Offline にしても、一度も訪れていない記事が表示されます。読んだ分だけ保持する設計では、ありえないことです。理由はページ内の1行で分かります。
try { await fetch('/robots.txt', { cache: 'no-store' }); }catch (e) { console.log('THREW: ' + e.message); } // THREW: Failed to fetchページにはネットワークがありません。ワーカーにはまだあるので、各ページをその場で取得して返していました。
Network.emulateNetworkConditions はターゲット単位で適用され、ワーカーは自分が配信するページとは別のターゲットです。このエミュレーションでは navigator.onLine も true のままなので、こちらを見てもオフラインだとは分かりません。サーバーそのものを止めれば、本当のテストになります。
lsof -ti:4321 | xargs kill止まったオリジンに対して試すと、訪問済みの記事は、スタイルシートと取得済みの画像を伴って完全に表示されました。未訪問のURLは正しい言語のオフラインページを返し、ステータスは503、要求したURLはアドレスバーに残ったままでした。
ナビゲーションの3xxはopaqueredirectとして届く
ナビゲーションの Request はリダイレクトモードが manual なので、3xxは opaqueredirect として返ってきます。type は 'opaqueredirect'、status は 0、ok は false、redirected も false です。response.redirected でリダイレクトかどうかを判定する if は条件が成り立つことがなく、中の処理は一度も実行されません。
opaqueredirect は中身を封じたレスポンスです。サーバーがリダイレクトを返したことだけを worker に伝え、リダイレクト先を含むそれ以外の情報は見せません。手を加えずにそのまま返せば、リダイレクトはブラウザ自身が処理します。
redirected が false なので、それを見ていた判定は一度も動かず、レスポンスは status 0 を拒否するコンストラクタへ落ちていきました。// opaqueredirect では `redirected` が false なので、ここは決して実行されない。if (response.redirected) return Response.redirect(response.url, 302);
if (response.ok) { /* … */ }
return offlineResponse(url, response.status); // status === 0offlineResponse はそこで new Response(body, { status: 0 }) を呼びますが、Response のコンストラクタは200から599しか受け付けません。コンストラクタは RangeError を投げ、その reject は respondWith の外まで伝わります。その結果、ワーカーがなければ普通に開けるURLで、読者にはブラウザのエラー画面が表示されます。301を返すローカルサーバーで試すと、結果は net::ERR_FAILED でした。
if (response.type === 'opaqueredirect' || response.status === 0) return response;opaqueredirectをそのまま返せば、ブラウザが自分でリダイレクトをたどり、同じURLが開きます。本番は今のところこの経路を通りません。2026年10月4日に確かめたところ、/ja、/privacy、末尾のスラッシュがない記事URLは、どれもリダイレクトなしで200を返しました。このガードは、サイトに最初のリダイレクト規則を加えたときのための備えです。
sharp.composite() の出力はmacOSとLinuxで異なる
ビルドはホーム画面用のアイコンを public/favicon.svg から生成し、--check モードで生成元とずれていないかを確かめています。PNGのバイト列を比べるチェックは、macOSでは通り、CIでは落ちます。
PWA icons are stale: public/pwa-icon-512-maskable.png — differs from 20575 bytes public/apple-touch-icon.png — differs from 6395 bytes手元ではこの2つは20,596バイトと6,399バイトです。差が出た2つのアイコンは、sharp.composite() を通る2つです。SVGからそのままラスタライズする残り2つは、バイト単位で一致します。libvips は macOS の arm64 と Linux の x64 とで合成もエンコードも異なるため、バイト列を比べるチェックは、何の問題もないアートワークに対して永遠に落ち続けます。
このチェックが捕まえたいのは、ファビコンを編集したのに誰も再生成しなかった場合、つまり入力の変化です。そこでチェックは入力どうしを比べます。SVGのハッシュ、アイコン仕様のハッシュ、そして各ファイルから読み直した寸法です。
{ "source": "public/favicon.svg", "sourceHash": "64655d5b744ddbff", "specHash": "ebf2f5ba3712cce2"}寸法はロックではなくファイルから読むので、切り詰められたPNGや手で置き換えられたPNGも捕まります。sourceHash を書き換えるとチェックは1で終了し、再生成すると0で終了します。
本番での確認:機内モードのiPhone、sw.jsのヘッダー、Safariの7日間
機内モードのiPhone
端末を機内モードにすると、一度もキャッシュしていないURLではオフラインページが表示されます。
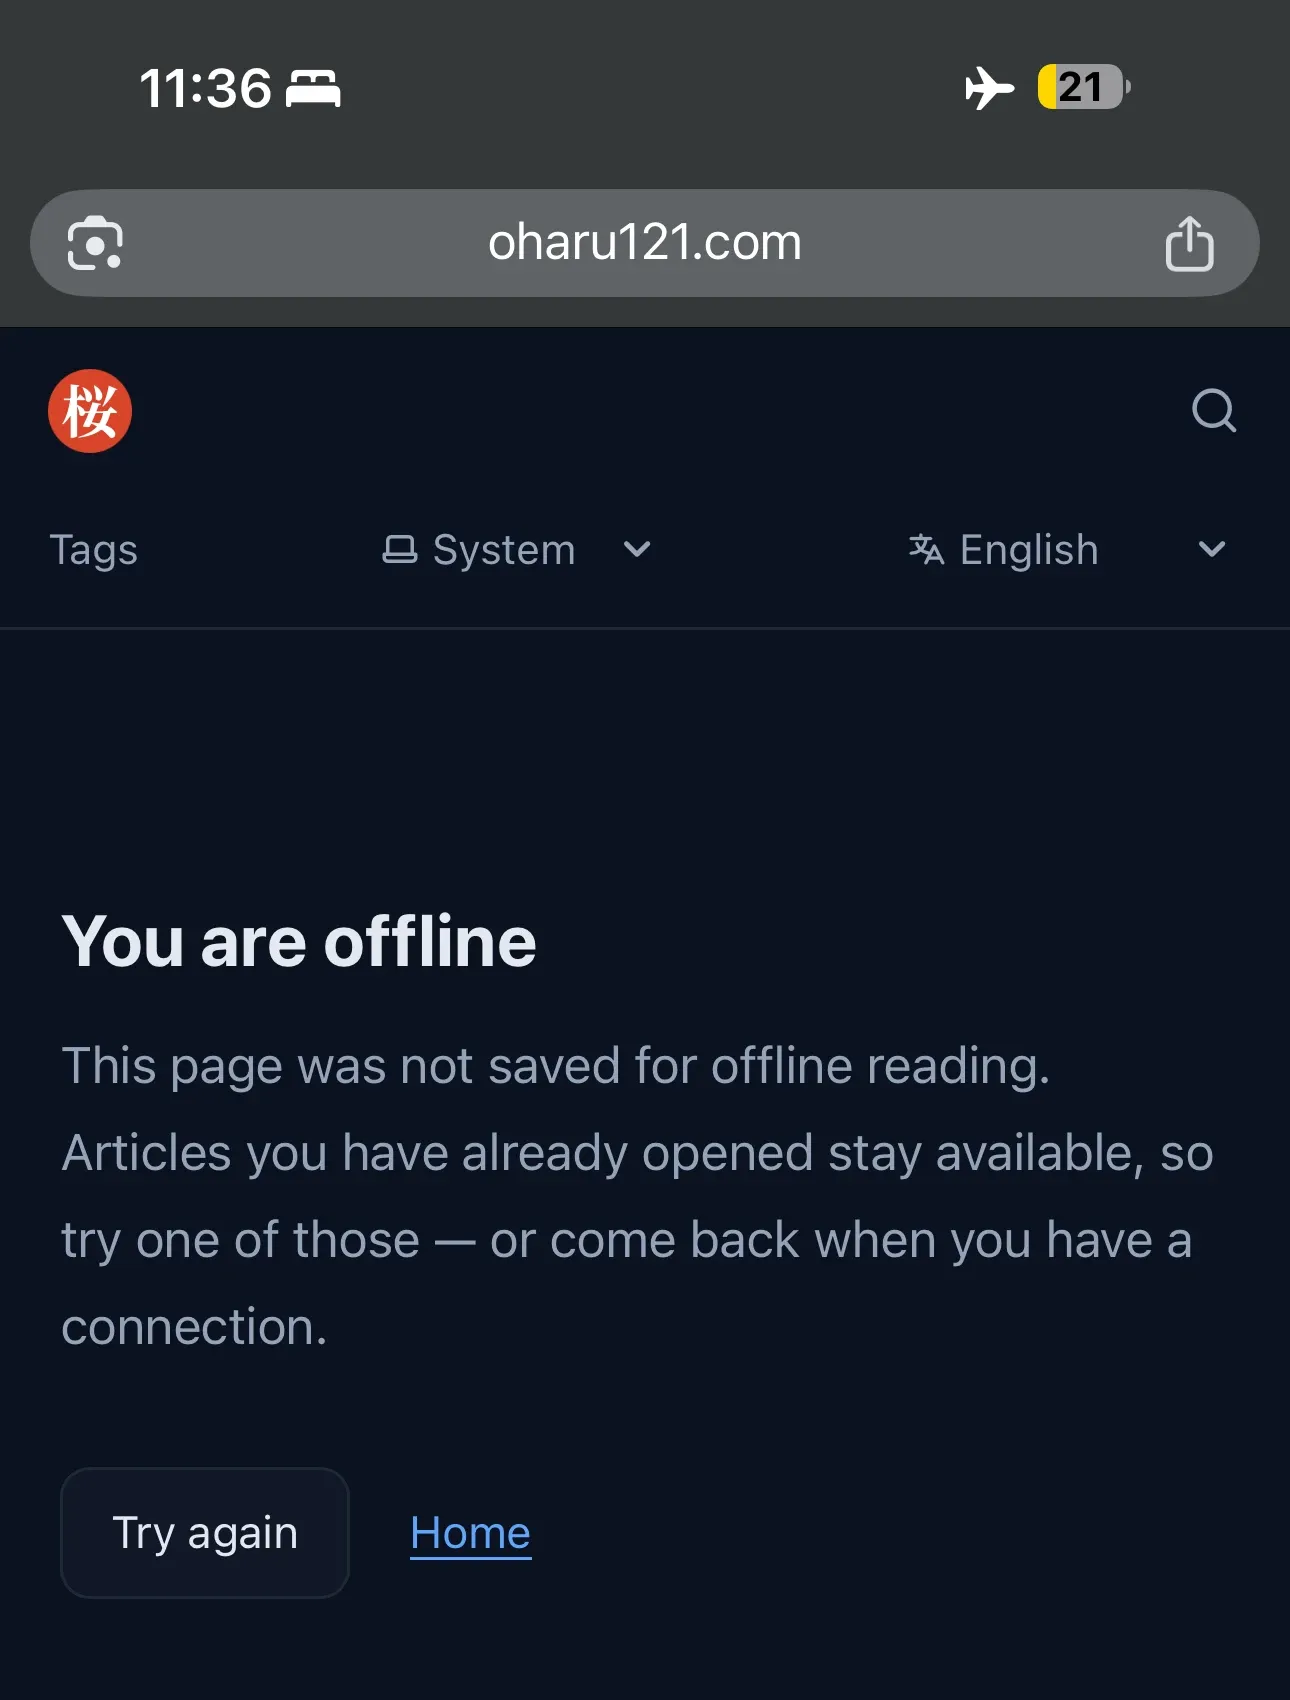
ページは navigator.onLine を見て2つの文言を選び分けます。DevTools のエミュレーションではこの値が true のままなので、デスクトップではオフラインの文言が一度も出ませんでした。実際に電波を切ればこの分岐が動き、ページは正しい文言を選びました。
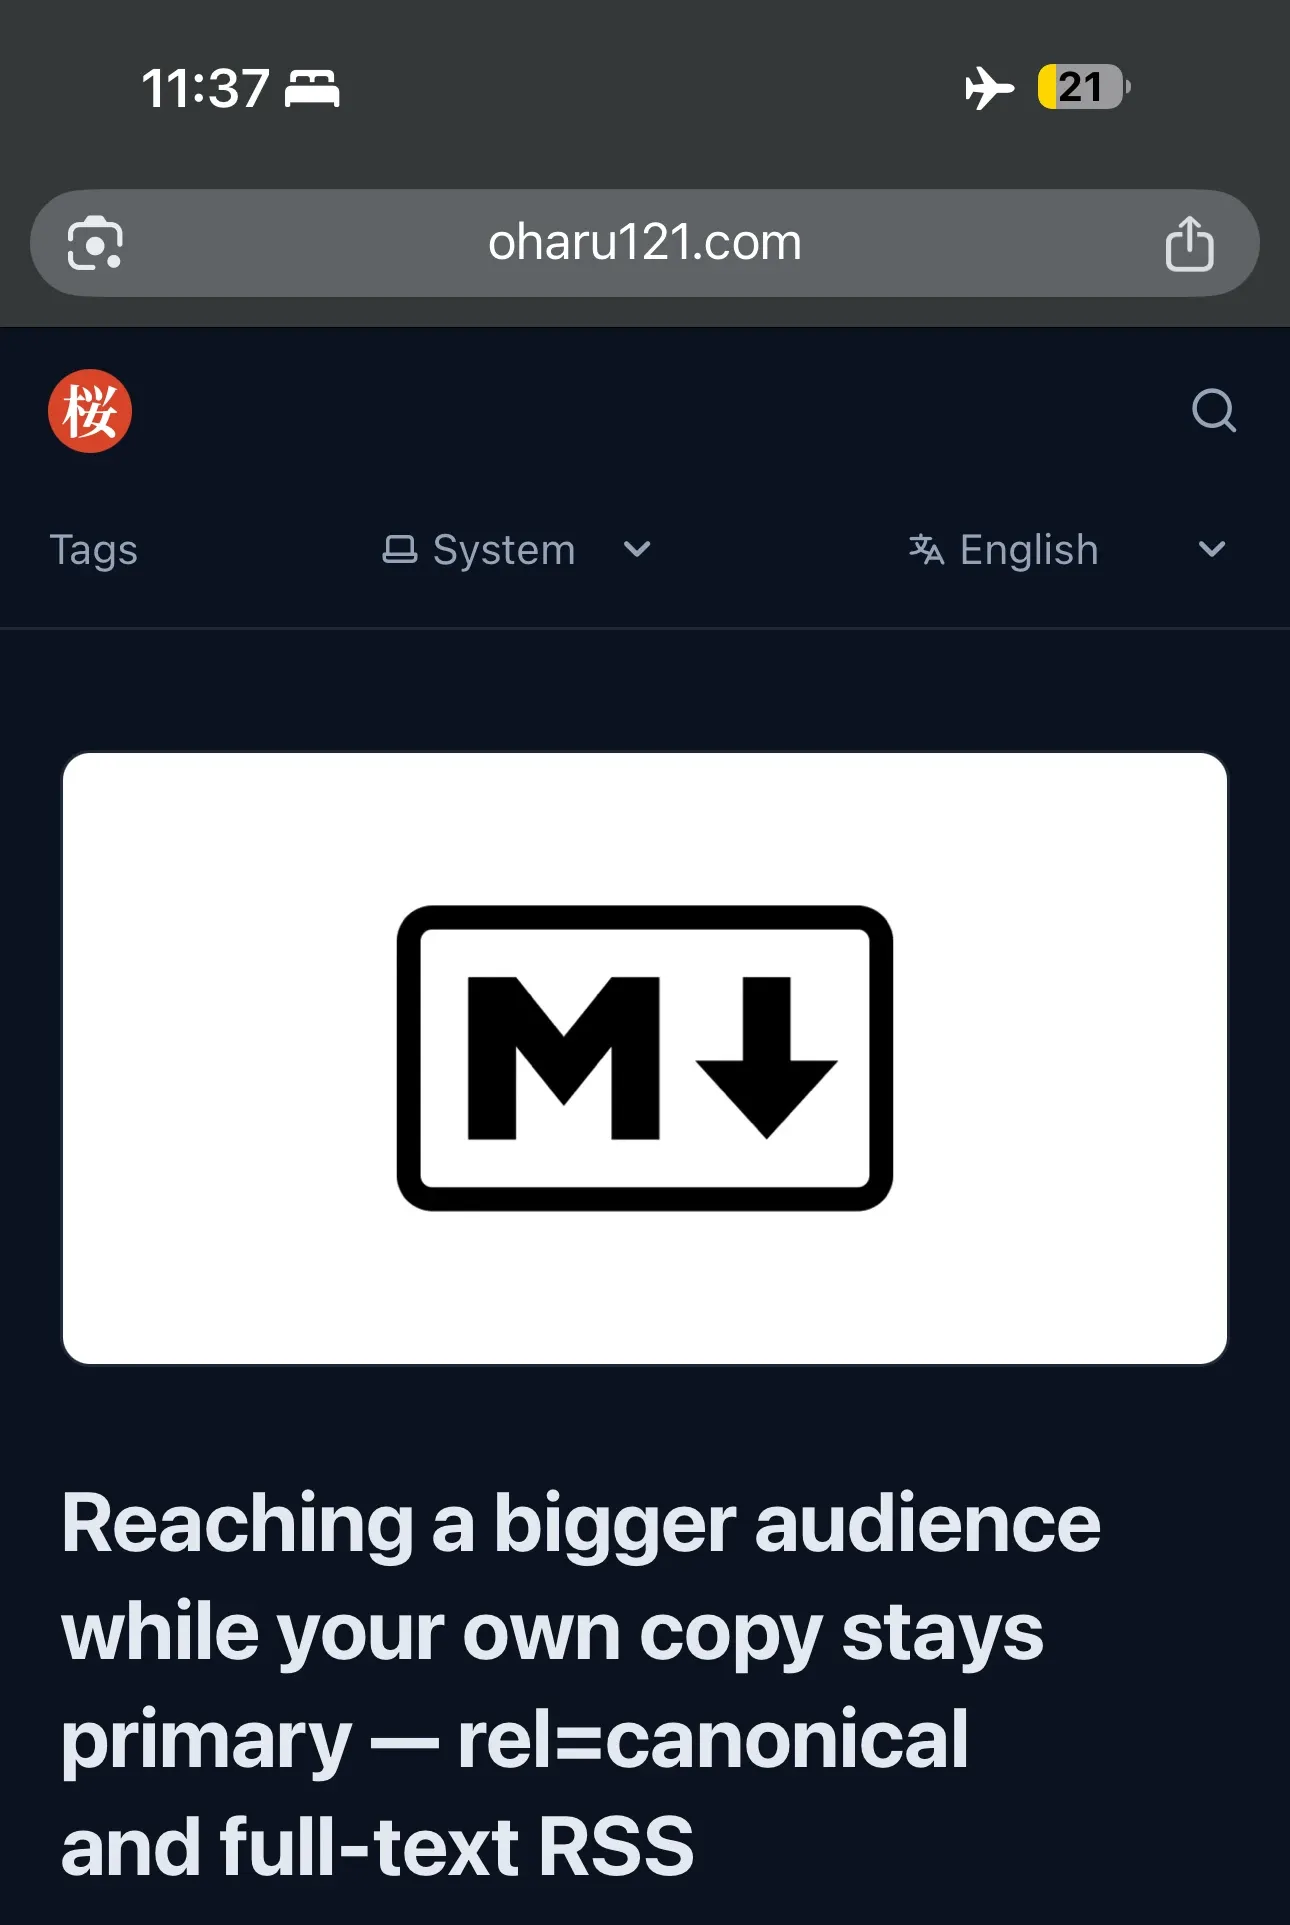
以前に読んだ記事は、電波なしで開きました。ヘッダー、言語切り替え、フッターはシェルから、記事本文とサムネイルは2つのランタイムキャッシュから来ています。
この2枚のスクリーンショットは、アドレスバーが見えている Safari の画面です。示しているのはタブでのオフライン閲覧だけで、インストールしたアプリについては何も分かりません。そこで次に、サイトをホーム画面に追加しました。
「ホーム画面に追加」のシートが示した名前は oharu で、これはマニフェストの short_name です。起動するとアドレスバーのない状態で開くので、display: standalone は反映されています。英語のルートからインストールすると、start_url によって英語のホームページが開きます。
—prebuilt でも vercel.json のヘッダーは本番に届く
Vercel のアダプターは自前で .vercel/output/config.json を書き、CIは --prebuilt でデプロイします。そのため vercel.json の headers がデプロイ後まで残るとは限りません。本番のレスポンスを見れば分かります。
入力curl -sSI https://oharu121.com/sw.js | grep -i cache-control出力cache-control: public, max-age=0, must-revalidateこのヘッダーは vercel.json にしか書いていないので、2つの設定はマージされています。後処理の工程は要りません。
未検証:ホーム画面での7日間
Safariを使った7日間のうちにそのサイトで一度も操作がなければ、Safari は Cache API を含む、スクリプトから書き込めるストレージを削除します。WebKit はホーム画面のウェブアプリをこの対象から外しており、そちらはアプリ自身の使用日数で数えます。
インストールしたアプリを1週間開かずに置いたとき、キャッシュが残るかどうかは未検証です。ホーム画面のアプリで navigator.storage.persist() が許可されるかどうかも未検証で、saveData の分岐も同様です。saveData のほうは、まともにエミュレートする方法がありません。
まとめ
設計を決めたのはビルドの計測です。サイト全体のHTMLは、翻訳できる図版を文書の中に持つため31MBになります。そこでワーカーは205KBのシェルを事前キャッシュし、ページは読んだ時点で50件まで保持します。
シェルには、すべてのページが読み込むものだけを入れます。1記事の図版だけが使うスタイルは、その記事を開いたときに oharu-assets に入ります。シェルとは分けているので、デプロイで破棄されることはありません。両者を見分けるにはビルド済みのHTMLが必要です。チャンクの名前は、どのページがそれをリンクしているかについて何も教えてくれないからです。
3つのチェックが誤った答えを返しました。DevTools のオフラインモードは、ワーカーをオンラインのままにしていました。リダイレクトのガードは、ナビゲーションでは常にfalseになるフィールドを読んでいました。アイコンのチェックは、2台の機械で決して一致しないバイト列を比べていました。修正後は、サーバーを実際に止めて試し、レスポンスの type を見て、アイコンは入力を比べるようにしています。
機内モードの端末で以前に読んだ記事を開くと、ちゃんと表示されました。
参考リンク
- Using Service Workers, including the fetch event and the Cache API
- Workbox: precaching dos and don’ts, on precaching only what every page needs
- Storage quotas and eviction criteria, including the 5 MiB localStorage limit
- Response() constructor, whose status must be in the range 200 to 599
- Response.type, listing opaqueredirect and what it means for a navigation
- WebKit: Full Third-Party Cookie Blocking and More, the seven-day cap and the home-screen exception
- WebKit: Updates to Storage Policy
- StorageManager.persist(), which prompts in some browsers
- NetworkInformation.saveData, marked limited availability rather than Baseline